환자 그룹 사이 단일세포 차등발현: 차이가 없어도 세포 단위 검정은 유전자의 최대 24%를 잡아냅니다. 실제 공여자로 잰 pseudobulk와 FindMarkers
같은 조건의 실제 공여자 8명을 4대 4로 35가지 방법으로 나누고, 세포 단위 검정(Seurat 기본값인 Wilcoxon, Scanpy 기본값과 같은 Welch t 검정)과 pseudobulk 검정 세 가지를 돌렸습니다. 실제 차이가 없는데도 세포 단위 검정은 유전자의 9~24%가 p<0.05였고, 나눔 한 번에 평균 최대 347개를 유의하다고 했습니다. pseudobulk는 5% 이하였습니다.
아래 숫자는 정답을 아는 시뮬레이션과, 설계상 정답을 아는 공개 10x 데이터에서 나왔습니다. 스크립트, 출력, 그림은 공개해 두었습니다. (English version)
요약
- Seurat(
FindMarkers, Wilcoxon 검정)과 Scanpy(rank_genes_groups, t 검정)의 기본 차등발현 검정은 세포 하나하나를 반복 측정으로 봅니다. - 사람 그룹을 비교할 때(환자 대 대조군, 처리한 공여자 대 처리하지 않은 공여자), 같은 사람에서 나온 세포는 서로 독립이 아닙니다. 그러면 사람마다 원래 다른 유전자가 그룹 사이에서도 다른 것처럼 보입니다.
- 실제 데이터로 쟀습니다. 같은 조건의 공여자 8명(Kang 등 2018, 자극하지 않은 PBMC)을 4명씩 두 그룹으로, 가능한 35가지 방법으로 모두 나눴습니다. 두 그룹을 가르는 것은 어떤 사람이 들어갔느냐뿐입니다.
- 세포 단위 검정은 유전자의 9~24%가 p<0.05였고(기대값 5%), 나눔 한 번에 BH 5% 「발견」이 평균 16~347개였습니다. 모두 위양성입니다. CD14+ 단핵구에서는 비교 한 번에 평균 347개였습니다(나눔별 156~770개).
- pseudobulk 검정(공여자마다 세포를 합친 뒤 edgeR, DESeq2, limma-voom)은 1.5~5.6%, 나눔당 위양성은 평균 많아야 3.3개였습니다.
- 진짜 2배 변화를 심어 두면 세포 단위 검정이 찾은 것의 20~58%가 가짜였고, pseudobulk는 2~7%였습니다. pseudobulk는 찾는 유전자가 적고, 작은 세포 유형에서 특히 그렇습니다.
어떤 질문을 다루나
단일세포 데이터에서 차등발현은 보통 두 가지로 씁니다.
- 같은 샘플 안에서 군집 사이 마커: 「3번 군집은 5번 군집과 무엇이 다른가?」 여기는 세포 단위 검정을 흔히 쓰고, 이 글은 이 경우를 재지 않았습니다.
- 사람 사이 조건 비교: 「CD14+ 단핵구에서 환자와 대조군 사이에 어떤 유전자가 다른가?」 여기서 반복 단위는 세포가 아니라 사람입니다. 이 글은 이 경우를 다룹니다.
Seurat의 차등발현 문서도 이 점을 직접 적습니다. 세포 하나하나를 독립된 반복으로 보는 분석은 생물학적 변이를 반영하지 못하고, 이런 유사반복(pseudoreplication)은 세포 수가 많아서 p값을 낮게 만들 수 있다고 적습니다. Squair 등(2021)과 Zimmerman 등(2021)이 이를 자세히 보였습니다. 저희는 많이 쓰는 데이터에서 문제가 얼마나 큰지, 확인할 수 있는 숫자로 보고 싶었습니다.
측정 조건
| 항목 | 내용 |
|---|---|
| 실제 데이터 | Kang 등 2018(GEO GSE96583, 배치 2): 루푸스 환자 8명의 PBMC를 섞어 유전형으로 다시 나눈(demuxlet) 데이터라 세포마다 공여자를 압니다. 자극하지 않은 세포 중 demuxlet 단일 세포이면서 세포 유형 라벨이 있는 12,315개만 썼고, 검정한 다섯 세포 유형에는 11,074개가 들어갑니다 |
| 세포 유형 | 모든 공여자에서 20개 이상인 5종: CD4 T(5,161개), CD14+ 단핵구(2,785), B(1,307), CD8 T(1,082), FCGR3A+ 단핵구(739) |
| 차이 없음 정답 | 공여자 8명을 4대 4로 나누는 35가지 방법 전부. 모든 발견은 가짜 |
| 심어 둔 정답 | 35가지 중 10가지에서, 검정한 유전자의 10%를 한쪽 그룹 세포의 수를 솎아 내는 방식(binomial thinning)으로 2배 바꿨습니다(절반은 올림, 절반은 내림). 데이터는 실제 수 그대로입니다 |
| 시뮬레이션 | 공여자 8명, 공여자마다 세포 100~400개, 유전자 2,000개, 공여자 사이 SD 0.25(대조 설정은 0), 10번 반복 |
| 세포 단위 검정 | 로그 정규화 값에 Wilcoxon 순위합 검정(Seurat 기본값)과 Welch t 검정(Scanpy 기본값 't-test'가 Welch t 검정) |
| pseudobulk 검정 | 공여자마다 수를 합친 뒤 edgeR quasi-likelihood, DESeq2(Wald), limma-voom |
| 발견 기준 | 모든 방법에 Benjamini-Hochberg 5% |
결과
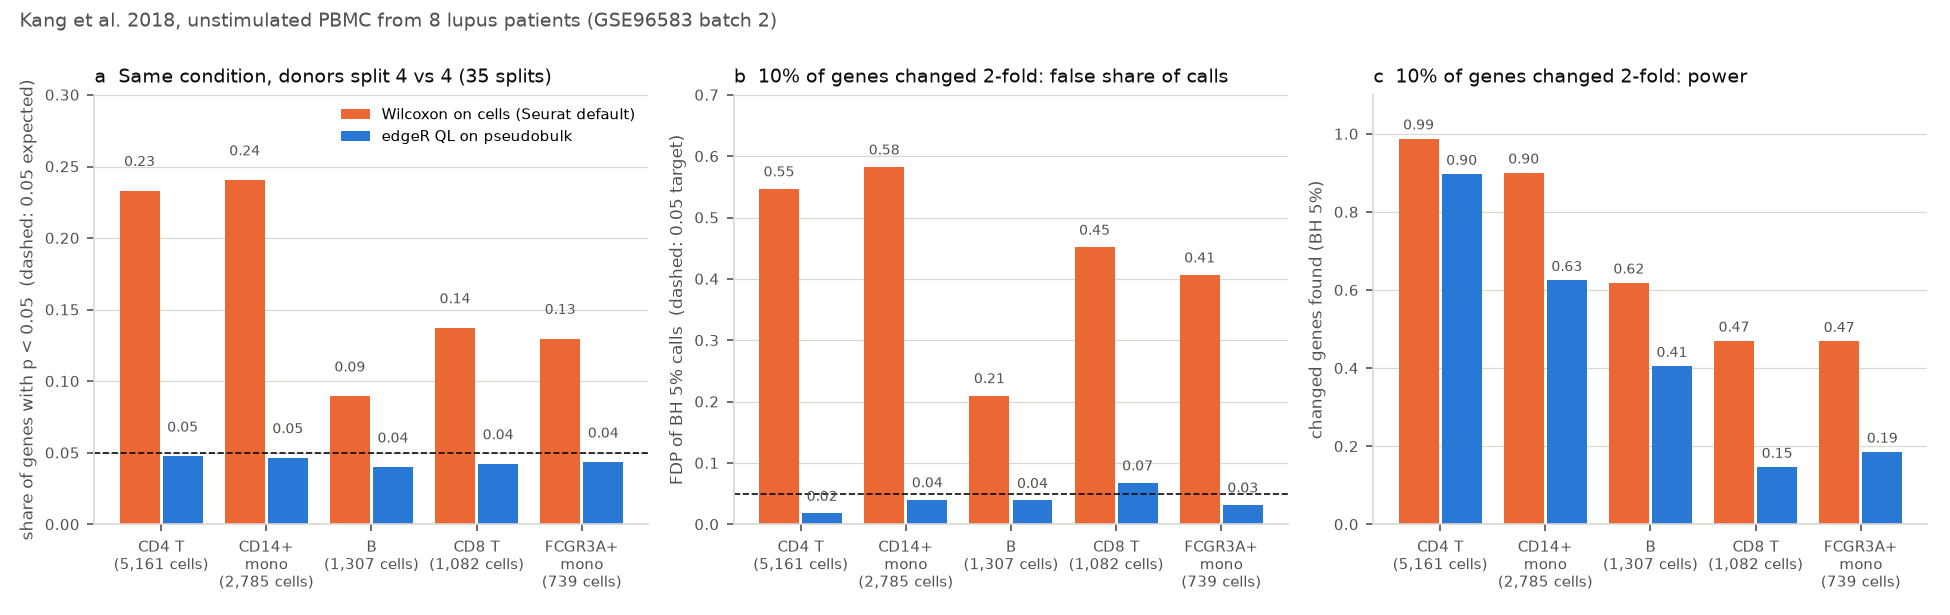
Kang 2018, 같은 조건, 공여자 4대 4 (35가지 나눔, 심어 둔 변화는 10가지):
| 세포 유형 | 세포 수 | p<0.05, 세포 단위 Wilcoxon | p<0.05, pseudobulk (edgeR / DESeq2 / limma) | 위양성, 나눔당 평균, Wilcoxon | 위양성, 나눔당 평균, pseudobulk | 심어 둔 변화: 발견 중 가짜 비율, Wilcoxon / pseudobulk | 심어 둔 변화: 검정력, Wilcoxon / pseudobulk |
|---|---|---|---|---|---|---|---|
| CD4 T | 5,161 | 0.233 | 0.048 / 0.029 / 0.054 | 271 | 1.5~3.3 | 0.55 / 0.02 | 0.99 / 0.84~0.90 |
| CD14+ 단핵구 | 2,785 | 0.241 | 0.046 / 0.032 / 0.046 | 347 | 0.2~1.2 | 0.58 / 0.04~0.06 | 0.90 / 0.61~0.63 |
| B | 1,307 | 0.090 | 0.040 / 0.015 / 0.049 | 18 | 0.2~0.3 | 0.21 / 0.02~0.04 | 0.62 / 0.23~0.43 |
| CD8 T | 1,082 | 0.137 | 0.042 / 0.015 / 0.056 | 77 | 0.7~0.9 | 0.45 / 0.04~0.07 | 0.47 / 0.07~0.16 |
| FCGR3A+ 단핵구 | 739 | 0.130 | 0.043 / 0.022 / 0.050 | 87 | 0.2~0.8 | 0.41 / 0.03~0.04 | 0.47 / 0.17~0.20 |
세포 단위 t 검정은 Wilcoxon과 거의 같은 숫자였습니다(모든 행은 저장소에 있습니다).
시뮬레이션 (10번 반복, 공여자 사이 SD 0.25): 그룹 사이 차이가 없을 때 세포 단위 검정은 유전자의 47%가 p<0.05였고 반복마다 위양성이 약 720개였습니다. pseudobulk는 4.95.3%, 위양성 0개였습니다. 공여자 사이 변이가 없으면 세포 단위 검정도 5.05.1%로 맞았습니다. 문제는 검정이 아니라 공여자입니다.
숫자가 말하는 것
1. 실제 공여자에서 기본 검정은 다르지 않은 그룹 사이에 「차이」를 수백 개 찾았습니다. CD14+ 단핵구에서 같은 조건끼리 4대 4로 비교하면 BH 5%에서 평균 347개가 나왔습니다(나눔별 156~770개). 모두 우연히 나눔과 맞아떨어진 사람 사이의 차이입니다. 35가지 나눔 모두에서 세포 단위 검정은 위양성을 하나 이상 냈습니다.
2. 가장 큰 세포 유형이 가장 심했습니다. 가장 큰 두 세포 유형(CD4 T 5,161개, CD14+ 단핵구 2,785개)에서 23~24%로 가장 높았습니다. 세포 단위 p값은 세포 수가 늘수록 작아지지만, 사람 사이 차이는 그대로이기 때문입니다. 세포 수만이 원인은 아닙니다. B 세포(1,307개)가 CD8 T 세포(1,082개)보다 덜했으니, 공여자가 얼마나 다른지도 세포 유형마다 다릅니다.
3. 진짜 변화가 있어도 해결되지 않습니다. 유전자 10%를 진짜로 2배 바꾸면 세포 단위 검정은 대부분을 찾았지만, 발견의 20~58%가 가짜였습니다. 높은 검정력도 진짜이고, 그 안에 섞인 잡음도 진짜입니다.
4. pseudobulk는 검정력으로 값을 치릅니다. 그룹마다 공여자 4명이면 pseudobulk는 CD4 T 세포에서 바뀐 유전자의 8490%를 찾았지만, 가장 작은 두 세포 유형에서는 720%였습니다. 대부분은 4대 4 사람이 주는 증거가 원래 그만큼이라서이고, pseudobulk 방법끼리도 조금 다릅니다(CD8 T: DESeq2 0.07, limma-voom 0.16).
5. pseudobulk DESeq2는 여기서도 보수적이었습니다 (차이가 없을 때 p<0.05가 1.5~3.2%). edgeR과 limma-voom은 5%에 가까웠습니다.
어떻게 하면 되나
- 세포가 아니라 사람을 비교하세요. 세포 유형마다 공여자별로 수를 합치고, 공여자들을 벌크 RNA-seq 방법으로 검정합니다.
- Seurat(v5)은 차등발현 문서에서 이 방법을 보여 줍니다.
AggregateExpression(obj, assays = "RNA", return.seurat = TRUE, group.by = c("condition", "donor", "cell_type"))로 합친 객체에FindMarkers(..., test.use = "DESeq2")를 돌립니다. - R만으로 하면, 저희 벤치마크가 세포 유형 하나에 돌리는 코드가 이렇습니다(
counts: 유전자 × 세포,donor와group은 세포마다).
library(edgeR)
donor <- factor(donor)
pb <- as.matrix(counts %*% Matrix::sparseMatrix(i = seq_along(donor), j = as.integer(donor), x = 1,
                                                dims = c(length(donor), nlevels(donor))))
colnames(pb) <- levels(donor)
pb_group <- factor(tapply(as.character(group), donor, `[`, 1)[colnames(pb)],
                   levels = c("control", "case"))   # 라벨은 데이터에 맞게. coef 2 = case 대 control
y <- calcNormFactors(DGEList(pb))
design <- model.matrix(~ pb_group)
fit <- glmQLFit(estimateDisp(y, design), design)
res <- glmQLFTest(fit, coef = 2)
topTags(res)
- 벤치마크처럼 드물게 검출되는 유전자는 먼저 거르세요(벤치마크는 세포의 5% 이상에서 검출된 유전자만 씁니다.
filterByExpr도 비슷한 일을 합니다). - 계획할 때 공여자 수를 먼저 세세요. 그룹마다 공여자 4명이면 큰 세포 유형의 큰 변화 위주로 찾을 수 있습니다. 공여자를 늘리면 pseudobulk 검정력이 오르고, CD4 T 세포와 작은 세포 유형의 차이가 보여 주듯 공여자당 세포 수도 영향을 줍니다.
- 세포 단위 검정은 그 검정이 답하는 질문에 쓰세요. 같은 샘플 안의 군집 마커입니다. 조건 사이
FindMarkers의 작은 p값은 세포가 다르다는 뜻이고, 그룹에 공여자가 섞여 있으면 사람마다 다른 거의 모든 유전자에서 그 말은 사실입니다.
한계
- 실제 데이터는 하나, 조직도 하나(PBMC), 공여자는 4대 4입니다. 그룹마다 공여자가 더 많은 연구는 pseudobulk의 검정력 손실이 덜하고, 세포 단위 검정의 부풀림 정도는 공여자가 얼마나 다른지에 달려 있습니다.
- 심어 둔 변화는 유전자 10%의 균일한 2배 변화이고, 수를 솎아 내는 방식으로 만들었습니다. 실제 효과는 크기가 제각각이고 같은 유형의 세포 사이에서도 다를 수 있습니다.
- 혼합 모형(공여자 안의 세포)과 MAST는 돌리지 않았습니다. 같은 문제의 다른 해법입니다.
- 공여자 그룹 사이 비교입니다. 같은 샘플 안의 군집 마커는 이 글이 다루지 않았습니다.
재현
데이터 받기, 스크립트, 출력, 그림: sbmlab-benchmarks/scrna-pseudobulk-de. bash download.sh가 Kang 2018 배치 2 파일을 받고(디스크에 약 60MB), KANG_CORES=12 Rscript kang_study.R data가 워크스테이션에서 모든 나눔을 약 2분에 돌립니다(R 4.3.3, edgeR 4.0.16, DESeq2 1.42.1, limma 3.58.1). 시뮬레이션은 Rscript sim_study.R로 돌고, 바뀔 때마다 CI에서 다시 돌립니다.
참고 문헌
- Kang HM, Subramaniam M, Targ S, et al. Multiplexed droplet single-cell RNA-sequencing using natural genetic variation. Nat Biotechnol 2018;36(1):89-94.
- Squair JW, Gautier M, Kathe C, et al. Confronting false discoveries in single-cell differential expression. Nat Commun 2021;12:5692.
- Zimmerman KD, Espeland MA, Langefeld CD. A practical solution to pseudoreplication bias in single-cell studies. Nat Commun 2021;12:738.
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics 2010;26(1):139-140.
함께 읽기
관련 글
배치 보정하고 검정하면 괜찮을까? 그룹이 배치에 고르지 않으면 ComBat이 목표 5%인 가짜 양성을 29%로 만든다
11월 4일 · 16 min read
Bioinformatics처음 R로 RNA-seq 분석했을 때 삽질 기록
2월 15일 · 11 min read
바이오인포매틱스bcftools와 GATK HaplotypeCaller를 GIAB HG002 정답으로 채점했습니다: SNP는 동점, 인델은 차이가 컸고 하드 필터는 진짜 변이를 지웠습니다
11월 14일 · 13 min read
바이오인포매틱스무작위 유전자 세트도 생존을 «예측»한다: TCGA로 재 보니 «최적 절단점»은 쓸모없는 지표의 절반 가까이를 유의하게 만들었다
11월 13일 · 17 min read