배치 보정하고 검정하면 괜찮을까? 그룹이 배치에 고르지 않으면 ComBat이 목표 5%인 가짜 양성을 29%로 만든다
ComBat이나 removeBatchEffect로 배치 효과를 지우고 그 데이터로 검정하는 흐름을 정답을 아는 시뮬레이션과 실제 Bioconductor 데이터(가짜 라벨)로 쟀습니다. 그룹이 배치에 고르지 않게 나뉘면 가짜 양성이 5%에서 28~29%로 늘었고, 배치를 limma 모델에 넣은 방법은 5%를 지켰습니다.
아래 숫자는 정답을 아는 시뮬레이션과, 공개 Bioconductor 데이터에 가짜 그룹 라벨을 붙인 실험에서 나왔습니다. 스크립트, 출력, 그림은 공개해 두었고, CI가 스크립트를 다시 돌려 공개한 숫자와 똑같이 나오는지 확인합니다. 고객 자료는 쓰지 않았습니다. (English version: Correct Batch Effects, Then Test?)
요약
- 흔한 흐름: ComBat이나 **
removeBatchEffect**로 배치 효과를 지우되 그룹 변수는 보호하고, 그 «깨끗한» 데이터로 limma 검정을 돌립니다. - 그룹이 배치에 고르게 나뉘어 있으면 거의 괜찮습니다. 효과 없는 유전자의 5.5~6.3%가 p < 0.05였습니다(목표 5%).
- 그룹이 배치에 고르지 않게 나뉘면 문제가 됩니다. 각 그룹 12개 중 11개가 한 배치에 몰리자 효과 없는 유전자의 28~29%가 p < 0.05였고, 유전자 10%가 실제로 바뀐 경우에는 유의하다고 나온 유전자의 61~62%가 가짜였습니다.
- 배치를 limma 모델에 넣은 방법(
~ batch + group)은 모든 설계에서 4.8~5.1%를 지켰습니다. 그룹과 배치가 겹칠수록 검정력은 떨어지는데, 그게 겹침의 정직한 대가입니다. - 실제 데이터(bladderbatch, 배치 5개, 어레이 57개)에 가짜 라벨을 붙이자, 보정 후 검정은 가장 불균형한 조건에서 반복마다 가짜 발견 404~563개를 냈습니다. 배치를 모델에 넣으면 0.4개였습니다.
문제가 되는 흐름
많은 분석 파이프라인이 이렇게 생겼습니다.
library(sva); library(limma)
clean <- ComBat(dat = expr, batch = batch, mod = model.matrix(~ group))   # 그룹 보호
fit   <- eBayes(lmFit(clean, model.matrix(~ group)))                     # 그다음 그룹 검정
removeBatchEffect(expr, batch = batch, design = model.matrix(~ group))를 쓰는 경우도 같습니다. 보정한 행렬은 PCA 그림에서 깔끔해 보여서 검정해도 될 것 같습니다.
이 문제는 Nygaard, Rødland, Hovig(2016)가 짚었습니다. 그룹을 «보호»하는 보정은 배치 효과를 추정할 때 그룹 라벨을 씁니다. 그런데 그 뒤의 검정은 보정된 값을 원래 그렇게 측정된 값처럼 다룹니다. 배치를 추정하면서 생긴 불확실성과 그 추정에 쓴 자유도가 검정에서 사라집니다. limma의 removeBatchEffect 도움말에도 이렇게 적혀 있습니다.
"This function is intended for plotting and data exploration purposes. This function is not intended to be used to prepare data for linear modeling by 'lmFit'. For linear modeling, it is better to include the batch factors in the linear model..." (limma 3.58.1)
그림과 탐색용으로 만든 함수이고 lmFit 전에 데이터를 준비하는 용도가 아니니, 선형 모델에는 배치를 모델 안에 넣으라는 설명입니다. 실제로는 얼마나 차이가 날까요? 직접 쟀습니다.
실험 설계
다섯 가지 방법을 비교했습니다. 모두 마지막에 limma lmFit + eBayes로 그룹 계수를 검정하고 유전자 전체에 BH를 적용합니다.
| 방법 | 검정 전 처리 | 검정 모델 |
|---|---|---|
| 배치 무시 | 없음 | ~ group |
| 배치를 모델에 | 없음 | ~ batch + group |
| ComBat (그룹 보호) | ComBat(mod = ~ group) | ~ group |
| ComBat (배치만) | ComBat(mod = NULL) | ~ group |
| removeBatchEffect (그룹 보호) | removeBatchEffect(design = ~ group) | ~ group |
시뮬레이션. 유전자 1,000개, 배치 2개에 시료 12개씩, 그룹마다 시료 12개입니다. 배치 1에는 그룹 A가 k개, B가 12 - k개, 배치 2는 반대입니다. k = 6이면 균형(6:6), k = 11이면 거의 겹침(11:1)입니다. 유전자마다 배치에 따른 이동과 크기 변화를 따로 줬습니다. 그룹 효과가 전혀 없는 경우(유의는 모두 가짜)와 유전자 10%가 ±1 log2 바뀐 경우를 설계마다 40번씩 반복했습니다.
정답을 아는 실제 데이터. Bioconductor 패키지 bladderbatch입니다. 방광 조직 어레이 57개가 배치 5개(11/18/4/5/19)에 나뉘어 있고, 평균이 높은 프로브 5,000개를 썼습니다. 반복마다 배치 안에서 가짜 그룹 라벨을 무작위로 붙였습니다. 배치 1, 3, 5에는 그룹 A 비율을 p로, 배치 2, 4에는 1 - p로 줬습니다. 배치를 알고 나면 이 라벨에는 생물학적 의미가 없으므로 유의는 모두 가짜입니다. p = 0.5가 균형, p = 0.9가 강한 불균형입니다. p마다 30번 반복했습니다.
R 4.3.3, limma 3.58.1, sva 3.50.0을 썼습니다.
결과
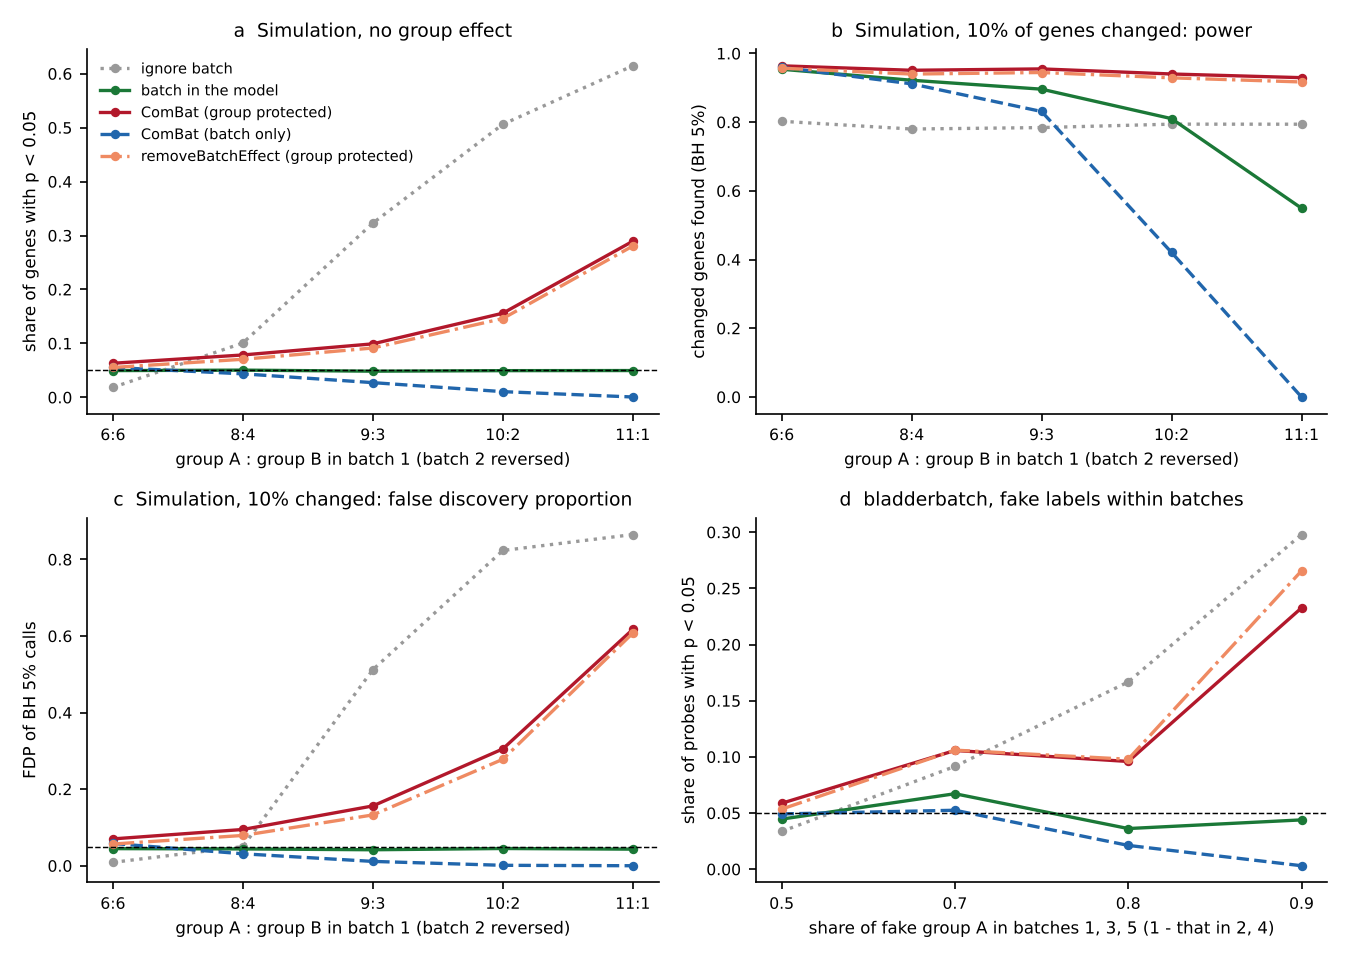 그림: a 그룹 효과 없음, p < 0.05 비율 / b 유전자 10% 변화, 검정력 / c 같은 조건의 가짜 발견 비율(FDP) / d bladderbatch 가짜 라벨. a, c, d의 점선은 목표 0.05입니다.
시뮬레이션, 그룹 효과 없음: p < 0.05인 유전자 비율 (정상이면 0.05)
| 방법 | 6:6 | 8:4 | 9:3 | 10:2 | 11:1 |
|---|---|---|---|---|---|
| 배치 무시 | 0.018 | 0.101 | 0.323 | 0.506 | 0.615 |
| 배치를 모델에 | 0.050 | 0.051 | 0.048 | 0.050 | 0.050 |
| ComBat (그룹 보호) | 0.063 | 0.079 | 0.099 | 0.156 | 0.289 |
| ComBat (배치만) | 0.055 | 0.044 | 0.027 | 0.011 | 0.001 |
| removeBatchEffect (그룹 보호) | 0.055 | 0.071 | 0.092 | 0.146 | 0.280 |
시뮬레이션, 유전자 10% 변화: BH 5%에서 검정력과 가짜 발견 비율(FDP) (6:6 → 11:1)
| 방법 | 검정력 | FDP (목표 0.05) |
|---|---|---|
| 배치 무시 | 0.80 → 0.79 | 0.009 → 0.87 |
| 배치를 모델에 | 0.95 → 0.55 | 0.045 → 0.043 |
| ComBat (그룹 보호) | 0.96 → 0.93 | 0.070 → 0.62 |
| ComBat (배치만) | 0.96 → 0 | 0.058 → 0 |
| removeBatchEffect (그룹 보호) | 0.96 → 0.92 | 0.057 → 0.61 |
bladderbatch, 가짜 라벨: 반복당 가짜 BH 발견 수 (p = 0.5 → 0.9)
| 방법 | 가짜 발견 | p < 0.05인 프로브 비율 |
|---|---|---|
| 배치 무시 | 0 → 414 | 0.034 → 0.298 |
| 배치를 모델에 | 0.1 → 0.4 | 0.045 → 0.044 |
| ComBat (그룹 보호) | 2.3 → 404 | 0.059 → 0.233 |
| ComBat (배치만) | 1.1 → 0 | 0.049 → 0.003 |
| removeBatchEffect (그룹 보호) | 1.6 → 563 | 0.053 → 0.266 |
숫자가 말하는 것
1. 그룹을 보호한 보정은 확신을 부풀리고, 불균형할수록 심해집니다. 6:6에서는 조금 높은 정도(5.56.3%)였지만 11:1에서는 2829%였고, 유의하다고 나온 유전자의 대부분이 가짜였습니다. 겉보기 검정력이 높게 유지되는(0.92~0.93) 것도 가짜 발견이 «찾은 것»으로 세어지기 때문입니다.
2. 배치를 모델에 넣은 방법만 약속을 지켰습니다. p < 0.05 비율은 모든 설계에서 0.0480.051, FDP는 0.0420.045였습니다. 대신 검정력은 11:1에서 0.95에서 0.55로 떨어졌습니다. 이건 결함이 아닙니다. 그룹 A가 거의 한 배치에 몰려 있으면 데이터에는 그룹과 배치를 가를 정보가 실제로 적고, 다섯 가지 중 이 방법만 그 사실을 인정합니다.
3. 그룹을 빼고 돌린 ComBat(mod = NULL)은 반대로 실패합니다. 배치 차이를 지우면서 배치와 겹친 그룹 차이까지 지웁니다. 효과가 없을 때는 안전해 보이지만, 11:1에서는 진짜 변화를 하나도 못 찾았습니다(검정력 0).
4. 시뮬레이션에서는 불균형한 설계에서 배치를 무시하는 것이 가장 나빴습니다. 배치 차이가 그대로 그룹 차이가 되기 때문입니다(11:1에서 효과 없는 유전자의 61%가 유의).
5. 실제 데이터도 시뮬레이션과 같은 방향이었습니다. bladderbatch에 가짜 라벨을 붙이자 p = 0.9에서 두 보정 방법 모두 반복마다 수백 개의 가짜 발견을 냈습니다. 배치를 모델에 넣으면 반복당 1개도 되지 않았습니다(평균 0.4개).
그럼 어떻게 하나
- 검정할 때는 배치를 모델에 넣습니다. limma라면
design <- model.matrix(~ batch + group)로lmFit,eBayes를 돌리고 그룹 계수를 봅니다. DESeq2, edgeR에서도 같은 생각으로 설계식을~ batch + group으로 씁니다. 위 limma 도움말이 권하는 방법입니다. - ComBat이나
removeBatchEffect는 그림에 씁니다. PCA나 히트맵처럼 보정된 값으로 p값을 계산하지 않는 곳입니다. - 분석 전에 설계표를 봅니다. 그룹과 배치로 교차표를 만들어 보세요. 거의 균형이면 방법 간 차이가 작습니다. 한쪽으로 쏠려 있으면 배치를 모델에 넣은 결과가 유의 유전자를 더 적게 낼 텐데, 그게 정직한 답입니다.
- 그룹과 배치가 완전히 겹치면(그룹 A가 전부 배치 1) 어떤 방법으로도 둘을 가를 수 없습니다. 해결은 분석이 아니라 실험 설계에 있습니다.
실제 분석에서
sbmlab에서 이런 분석을 맡는 사람에게 실제로 어떤지 물었습니다.
배치를 나눠 받은 샘플, 실험일이 달랐던 경우, 장비 사용 날짜도 달라서 어떻게 통합 분석할지 난감한 경우가 있습니다. ComBat을 비롯해 여러 R 기반 도구를 써 봤고, RUV 같은 것도 써 봤습니다.
고객이나 공동연구자에게 「설계표부터 보자」고 말할 때도 있는데 조심스럽습니다. 제가 실험한 게 아니니까 물어보는 데 한계가 있습니다.
그래서 그룹과 배치의 교차표는 분석 초기에 요청할 가치가 있습니다. 누가 실험을 어떻게 했는지 묻는 게 아니라, 데이터에 대한 질문이기 때문입니다. 원치 않는 변동 요인을 추정해 모델에 공변량으로 넣는 RUV 계열은 «배치를 모델에 넣기»에 가까운 방식인데, 이번에는 시험하지 않았습니다.
한계
- 시뮬레이션 설계 하나(배치 2개, 각 시료 12개, 유전자별 배치 이동과 크기)와 실제 데이터 하나입니다. 배치가 많고 작은 경우나, 카운트 데이터를 DESeq2, edgeR로 바로 분석하는 경우에는 크기가 다를 수 있습니다. 방향은 Nygaard 등의 결과와 같습니다.
- 반복 40번, 30번입니다. 「한 번이라도 가짜 발견이 나온 반복 비율」(
batch_study.out에 있음)은 95% 구간이 ±0.07~0.09쯤이라 칸 하나하나는 흔들립니다. 불균형에 따른 추세는 분명합니다. - bladderbatch 프로브들은 서로 상관이 있어서 반복당 가짜 발견 수가 들쭉날쭉합니다. 숫자 하나보다 p에 따른 추세를 보세요. 보정 방법들은 p = 0.7과 0.8 사이에서 한 번 꺾이고, 배치를 모델에 넣은 방법도 p = 0.7에서 0.067이 나왔습니다. 이유는 따로 확인하지 않았고, 상관된 프로브로 30번만 반복한 데서 오는 흔들림일 가능성이 큽니다.
직접 돌려 보기
스크립트, 출력, 점수, 그림: sbmlab-benchmarks/batch-correction-unbalanced. R 4.3.3, limma, sva, bladderbatch가 있으면 Rscript batch_study.R > batch_study.out이 몇 분 걸립니다.
참고문헌
- Nygaard V, Rødland EA, Hovig E. Methods that remove batch effects while retaining group differences may lead to exaggerated confidence in downstream analyses. Biostatistics 2016;17(1):29-39. doi:10.1093/biostatistics/kxv027
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics 2007;8(1):118-127. (ComBat)
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res 2015;43(7):e47.
- Dyrskjøt L, et al. Gene expression in the urinary bladder: a common carcinoma in situ gene expression signature exists disregarding histopathological classification. Cancer Res 2004;64(11):4040-4048. (bladderbatch 데이터)