DIA-NN 2.7.0 받기와 업그레이드: 정답 아는 데이터로 2.3.2와 비교해 보니
DIA-NN 2.7.0을 설치하고, 2.3.2로 채점했던 SWATH 파일 6개를 같은 설정으로 다시 돌렸습니다. 파일당 찾은 단백질은 6% 늘었고 두 버전이 함께 정량한 단백질에서는 정확도가 비슷했지만, 새로 채워진 약한 값 때문에 대장균 정확도는 85%에서 77%로 내려갔습니다. 설치 방법, .wiff 함정, 명령어, 업그레이드 점검표를 정리했습니다.
DIA-NN 2.7.0은 2026년 9월 16일에 나왔고 10월 16일에 정식 배포 채널로 올라왔습니다. 같은 PC에 설치해서, 정답을 아는 벤치마크에서 2.3.2로 채점했던 SWATH 파일 6개를 같은 설정으로 다시 돌렸습니다. 아래 숫자는 모두 그 두 실행에서 나왔습니다. 스크립트, 로그, 단백질 행렬은 sbmlab-benchmarks에 있습니다. (English version: DIA-NN 2.7.0: Download, Upgrade From 2.3.2)
요약
| DIA-NN 2.3.2 | DIA-NN 2.7.0 | |
|---|---|---|
| 파일당 찾은 단백질(6개 평균) | 8,198 | 8,708 (+6.2%) |
| 파일당 찾은 전구체(6개 평균) | 100,450 | 105,919 (+5.4%) |
| 비율을 잴 수 있는 단백질 그룹(사람 / 효모 / 대장균) | 5,477 / 2,374 / 446 | 5,574 / 2,533 / 605 |
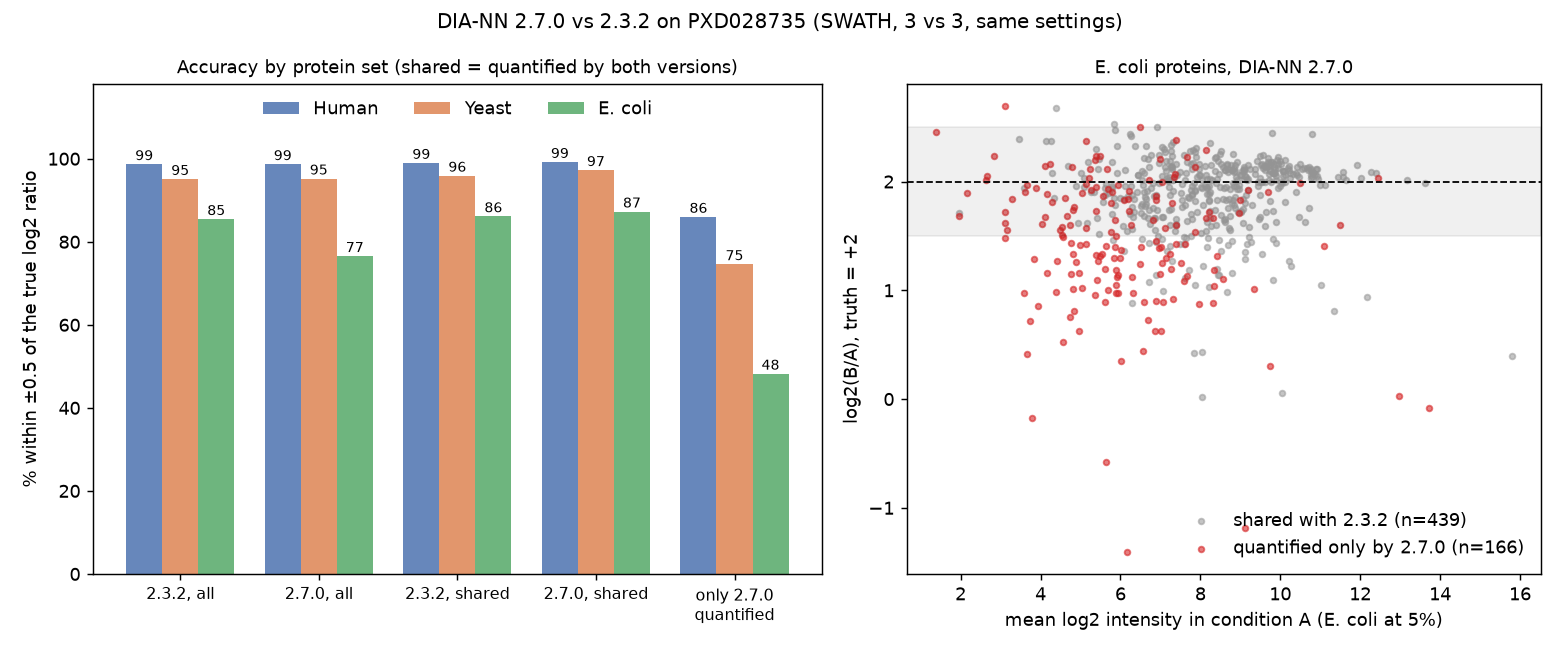
| 그 전체에서 정답 ±0.5 안에 든 비율 | 98.6% / 95.1% / 85.4% | 98.7% / 95.2% / 76.5% |
| 두 버전이 모두 정량한 8,097개만 | 99.0% / 95.9% / 86.1% | 99.2% / 97.2% / 87.2% |
| 걸린 시간(라이브러리 + 검색) | 11분 + 6시간 17분 | 13분 + 9시간 10분(아래 단서 참고) |
- 2.7.0이 더 많이 찾습니다. 파일당 단백질이 약 6% 늘었습니다. 2.3.2와 2.7.0 사이에는 판이 다섯 개 있고, 릴리스 노트도 증가를 예고했습니다(2.5.0 «단백질 수 대폭 증가», 2.7.0 «몇 % 증가»).
- 같은 단백질에서는 정확도가 비슷합니다. 두 버전이 모두 정량한 8,097개에서는 세 종 모두 2.7.0이 정답 ±0.5 안에 조금 더 자주 들었습니다.
- 새로 정량된 단백질이 약한 고리입니다. 2.7.0에서만 비율이 나온 단백질 그룹이 615개인데, 대부분 2.3.2가 비워 두었던 약한 값이고, 그중 대장균은 48%만 정답 ±0.5 안에 들었습니다. 2.7.0 안에서 이들이 대장균 정확도를 87.2%(공통 단백질)에서 76.5%(전체)로 끌어내립니다.
- SCIEX .wiff 파일이면 새로 푼 2.7.0 폴더는 파일을 건너뜁니다. 그래도 종료 코드는 0입니다. 해결법은 아래에 있습니다.
데이터
PRIDE PXD028735(Van Puyvelde 외, Scientific Data 2022)는 사람, 효모, 대장균 단백질 소화물을 정해진 비율로 섞은 데이터입니다. 이 가운데 SCIEX TripleTOF 6600+ SWATH 6개(조건마다 3개)를 썼습니다.
| 사람 | 효모 | 대장균 | |
|---|---|---|---|
| 조건 A | 65% | 30% | 5% |
| 조건 B | 65% | 15% | 20% |
| 기대 log2(B/A) | 0 | −1 | +2 |
단백질마다 정답을 알기 때문에, 새 버전이 찾은 단백질 수만 믿지 않고 실제 데이터로 확인할 수 있습니다. FASTA는 이전 글들과 같은 Swiss-Prot 사람, 효모, 대장균 파일(31,695개)입니다.
1단계: 받기
DIA-NN은 GitHub vdemichev/DiaNN에 있습니다. 2.x 판은 별도의 2.7.0 릴리스가 아니라 «DIA-NN 2.0»이라는 릴리스에 파일로 붙어 있어서, 그 릴리스의 파일 목록까지 내려가야 합니다.
DIA-NN-2.7.0-Academia.msi(Windows, GitHub 표시 345MB)DIA-NN-2.7.0-Academia-Linux.zip(Linux, 360MB)
이 파일은 학술용(Academia) 판이고, README는 «기능 제한, 비영리 학술 연구용»이라고 적었습니다. 기능이 전부 들어간 Enterprise 판은 Aptila Biotech나 Thermo Fisher Scientific을 통해 판매합니다. 2.x 각 판의 릴리스 노트는 GitHub 토론 «DIA-NN 2.0-series Updates»에 있습니다.
2.7.0 릴리스 노트를 줄이면 이렇습니다. 성능 개선(특히 이질적인 실험, 적은 시료량, InfinDIA 모드에서 «단백질 수 몇 % 증가» 예상), 통계와 그림의 방법 설명 보강, 희소한 MS1 스펙트럼에서 드물게 걸리던 무결성 검사 수정, GUI 수정 두 건, 경로 분석 변경, DDA용 --fwhm 옵션 추가입니다.
2.3.2에서 올라온다면 2.5.0부터 2.6.1까지의 노트도 읽어야 합니다. 그중 두 판이 흔히 쓰는 단백질 행렬을 바꿨습니다. 2.5.1은 «MBR을 쓸 때 행렬을 라이브러리 q값 필터 없이 만든다», 2.6.0은 «MBR을 쓸 때 출력 행렬에 'Global' 필터를 쓴다»입니다. 그래서 명령줄이 똑같아도 두 버전은 report.pg_matrix.tsv를 같은 기준으로 거르지 않습니다. 이 문제는 채점 단계에서 다룹니다.
2단계: 설치 (옛 버전은 남겨 두기)
Windows에서는 .msi를 두 번 눌러 평소처럼 설치하면 됩니다. 저는 비교를 위해 2.3.2를 그대로 두고 싶어서, 설치하지 않고 설치 파일을 따로 폴더에 풀었습니다.
msiexec /a C:\DIA-NN\dl\DIA-NN-2.7.0-Academia.msi /qn TARGETDIR=C:\DIA-NN\2.7.0
그러면 C:\DIA-NN\2.7.0에 diann.exe(명령줄)와 DIA-NN.exe(GUI)가 생기고, 옛 C:\DIA-NN\2.3.2는 그대로 남습니다. 이렇게 푼 사본은 시작 메뉴 바로가기와 제거 항목이 없고, 설치 프로그램이 해 주는 사전 구성 요소 설치도 건너뜁니다. 여기서는 같은 PC에 2.3.2를 먼저 정상 설치해 두었기 때문에 문제없이 돌았습니다. 버전은 diann.exe를 인자 없이 실행해서 첫 줄의 DIA-NN 2.7.0 Academia로 확인합니다.
Linux에서는 Linux판을 풀고 diann-linux를 실행합니다. 자세한 내용은 튜토리얼에 있습니다. 여기서 중요한 제약이 하나 있습니다. Linux 기본판은 SCIEX .wiff를 읽지 못합니다(DIA-NN README가 Linux 기본판에서 지원한다고 적은 형식은 .d, .raw, .mzML, .dia). Windows를 쓰거나 .mzML로 변환해야 합니다. 저는 Windows판으로 돌렸습니다.
3단계: .wiff 함정
2.7.0의 첫 검색은 2분 35초 만에 종료 코드 0으로 끝났습니다. 실제로는 아무것도 처리하지 않았습니다. 화면 출력에는 0 files will be processed라는 줄과 함께 이런 오류가 있었습니다.
ERROR: cannot find Clearcore2.Data.AnalystDataProvider.dll, please copy .dll files as described in
https://github.com/vdemichev/DiaNN?tab=readme-ov-file#raw-data-formats. Wiff files will be skipped.
설치 파일에는 SCIEX 파일을 읽는 라이브러리가 들어 있지 않습니다. DIA-NN README는 ProteoWizard(64비트, 제조사 형식 지원판)를 설치한 뒤, 이름에 «Clearcore»나 «Sciex»가 들어간 .dll을 모두 DIA-NN 폴더로 복사하라고 안내합니다. 제 2.3.2 폴더에는 처음 설정할 때 넣어 둔 그 파일 23개가 있어서, 그대로 복사했더니 두 번째 실행은 6개 파일을 모두 읽었습니다.
업그레이드할 때 얻은 교훈은 두 가지입니다.
- 새 DIA-NN 폴더에는 SCIEX DLL이 없습니다. 새 폴더에 설치했다면 다시 복사해야 합니다.
- 종료 코드 0은 성공이 아닙니다. 출력 앞부분의
N files will be processed줄과, 화면(또는 GUI) 출력 끝에 DIA-NN이 모아 보여 주는 경고와 오류 목록을 확인하세요. 저장되는report.log.txt에는 그 목록이 다시 나오지 않고, 오류는 파일 앞부분에 있습니다.
4단계: 2.3.2와 같은 설정
2.7.0으로 예측 라이브러리를 새로 만들었습니다. 설정은 2.3.2와 같습니다(트립신, 놓친 절단 1개, 펩타이드 730개 아미노산, 전하 24, 전구체 m/z 300~1800, 시스테인 카바미도메틸 고정, 메티오닌 산화 가변). 2.3.2 라이브러리를 2.7.0에서 그대로 써도 되는지는 시험하지 않았고, 라이브러리와 검색을 같은 판에 맞추려고 새로 만들었습니다.
diann.exe --fasta C:\diann-hye\hye_sp.fasta --fasta-search --predictor --gen-spec-lib ^
  --out-lib C:\diann-hye\v270\lib\hye.parquet --cut K*,R* --missed-cleavages 1 ^
  --min-pep-len 7 --max-pep-len 30 --min-pr-charge 2 --max-pr-charge 4 ^
  --min-pr-mz 300 --max-pr-mz 1800 --min-fr-mz 200 --max-fr-mz 1800 ^
  --unimod4 --var-mods 1 --var-mod UniMod:35,15.994915,M --threads 24 --verbose 1
2.3.2와 마찬가지로 라이브러리는 hye.predicted.speclib라는 이름으로 저장됐고, 단백질 31,635개에서 나온 전구체 6,370,129개로 크기도 같았습니다.
이어서 검색입니다. 런 간 매칭(--reanalyse)을 켜고, 출력 경로만 빼면 2.3.2 실행과 똑같습니다.
diann.exe --f <.wiff 파일 6개> --lib C:\diann-hye\v270\lib\hye.predicted.speclib ^
  --fasta C:\diann-hye\hye_sp.fasta --out C:\diann-hye\v270\out\report.parquet ^
  --temp C:\diann-hye\v270\quant --threads 24 --verbose 1 --qvalue 0.01 --matrices ^
  --unimod4 --var-mods 1 --var-mod UniMod:35,15.994915,M --reanalyse --rt-profiling
--temp는 파일마다 생기는 .quant 파일을 다른 폴더에 저장하게 합니다. 이 옵션이 없으면 DIA-NN이 원자료 옆에 저장해서, 2.3.2의 .quant 파일을 덮어썼을 겁니다.
5단계: 채점
report.pg_matrix.tsv를 이 연재의 다른 글과 같은 규칙으로 채점했습니다. 단백질 그룹은 조건마다 3개 중 2개 이상 값이 있어야 하고, log2(B/A)는 log2 세기 평균의 차이이며, 정답과 ±0.5 이내면 맞은 것으로 셉니다. 이름에 여러 종이 섞인 단백질 그룹은 빼는데, 두 버전 모두 하나도 없었습니다.
기본 행렬 필터가 두 버전 사이에 바뀌었기 때문에(1단계), 각 report.parquet에서 같은 필터(전구체 Q ≤ 0.01, 단백질 그룹 Q ≤ 0.01)로 단백질 행렬을 다시 만들어 채점해 보기도 했습니다. 결과는 같았습니다. 대장균 정답 ±0.5 비율이 2.3.2 421개 중 87.6%에서 2.7.0 604개 중 76.5%로 내려갔습니다.
대장균 정확도가 떨어진 이유
요약 표만 보면 2.7.0의 대장균 정확도가 85.4%에서 76.5%로 나빠진 것처럼 보입니다. 단백질을 «두 버전이 모두 정량한 것»과 «2.7.0에서만 정량된 것»으로 나눠 보면 무슨 일이 있었는지 보입니다.
| 종 | 공통, 2.3.2 | 공통, 2.7.0 | 2.7.0만 | 2.7.0만: log2 비율 중앙값(정답) |
|---|---|---|---|---|
| 사람 | 99.0% (5,353개) | 99.2% | 86.0% (221개) | −0.03 (0) |
| 효모 | 95.9% (2,305개) | 97.2% | 74.6% (228개) | −0.85 (−1) |
| 대장균 | 86.1% (439개) | 87.2% | 48.2% (166개) | 1.48 (+2) |
대부분 새로 찾은 단백질이 아닙니다. «2.7.0에서만» 정량된 615개 중 391개는 2.3.2 행렬에도 있었고, 값이 모자라 3개 중 2개 규칙을 넘지 못했을 뿐입니다. 대장균은 166개 중 156개가 그렇고, 그중 155개는 2.3.2에서 조건 A의 값이 0개나 1개였습니다. 조건 A는 대장균이 시료의 5%뿐인 쪽입니다. 2.7.0은 그 약한 값을 채웠습니다.
검출 한계 근처의 값은 흔들리고 한쪽으로 치우칩니다. 2.7.0에서만 정량된 단백질은 조건 A의 log2 세기 중앙값이 공통 단백질보다 사람은 4.0(약 16배 약함), 효모는 3.3, 대장균은 2.4 낮습니다. 이 단백질들은 비율이 더 흩어집니다(정답이 0인 사람도 정답 ±0.5 비율이 99.2%에서 86.0%로 내려감). 대장균은 거기에 더해 0 쪽으로 끌려옵니다. 그림 오른쪽에서 빨간 점 대부분이 +2 선 아래에 있고 중앙값은 1.48입니다. 이 대장균 단백질들을 +2에 중심이 오도록 옮기면 정답 ±0.5 비율이 48%에서 65%가 되고, 나머지 차이는 흩어짐 때문입니다.
대장균이 가장 크게 타격을 받은 이유는 두 가지입니다. 새로 정량된 단백질이 대장균 묶음의 27%를 차지합니다(효모 9%, 사람 4%). 그리고 대장균에서는 그 값 대부분이 실험 전체에서 신호가 가장 약한 쪽, 대장균 5% 조건의 값입니다.
정리하면, 두 버전이 함께 정량한 단백질에서 2.7.0의 정확도는 2.3.2와 비슷합니다. 2.7.0은 약한 쪽에도 숫자를 더 많이 채우는데, 그 약한 쪽이 덜 정확합니다. 이 약한 값 가운데 진짜 낮은 신호와 런 간 매칭의 잘못된 연결이 각각 얼마인지는 이번 실행으로 가를 수 없습니다.
결측값 필터를 엄격하게 해도 해결되지 않습니다. 조건마다 3개 중 3개 값이 있어야 한다는 기준을 걸어도 2.7.0의 대장균 단백질은 562개가 남고, 정답 ±0.5 비율은 79.2%였습니다(2.3.2는 367개 중 89.9%). 2.7.0의 행렬은 값이 찬 칸이 97.1%로 2.3.2(95.0%)보다 촘촘해서, 약한 단백질도 대개 3개 중 3개를 통과합니다. 업그레이드 뒤 중간 크기 변화의 유의한 단백질이 갑자기 늘었다면, 믿기 전에 그 단백질들의 세기부터 보세요.
걸린 시간
2.7.0은 9시간 10분, 2.3.2는 6시간 17분이 걸렸습니다. 차이의 대부분은 .wiff 파일 읽기입니다. 파일 읽기 12번(검색 두 번에 6개씩)이 199분에서 326분으로 64% 늘었고, 나머지 단계는 178분에서 224분으로 25% 늘었습니다. 두 설치본은 DIA-NN 자체의 .wiff 읽기 파일이 서로 다르고, 그 사이 릴리스 노트에는 원자료 읽기 관련 변경이 있으니 버전 탓일 수 있습니다. 다만 버전마다 한 번씩, 다른 시각에 돌려서 버전과 PC 상태를 가를 수 없습니다. 속도를 제대로 비교하려면 같은 PC에서 두 버전을 연달아 돌려야 합니다.
업그레이드 점검표
- 새 버전은 따로 폴더에 설치하고, 비교가 끝날 때까지 옛 버전을 남겨 둡니다.
- 최신판 노트만이 아니라 건너뛰는 모든 판의 릴리스 노트를 읽습니다. 2.5.1과 2.6.0에서 행렬 필터가 바뀌었습니다.
- Windows에서 SCIEX .wiff를 쓴다면 Clearcore, Sciex DLL을 새 폴더로 복사합니다. Linux 기본판은 .wiff를 읽지 못하니 .mzML로 변환합니다.
- 종료 코드를 믿지 않습니다.
N files will be processed줄과 화면 출력 끝의 경고 목록을 확인합니다. - 옛
.quant파일이 아직 필요하면--temp를 새 폴더로 지정합니다. report.stats.tsv에서 파일당 단백질 수를 비교하고, 두 버전이 함께 정량한 단백질과 새로 정량된 단백질을 따로 비교합니다.- 새로 정량된 단백질은 보고하기 전에 세기를 확인합니다.
한계
- 데이터 하나(TripleTOF 6600+ SWATH, 3 대 3)에 버전마다 한 번씩 돌렸습니다. Orbitrap이나 timsTOF 데이터는 다를 수 있고, 릴리스 노트는 이질적인 실험과 적은 시료량에서 개선이 가장 크다고 했는데 이 데이터는 그런 경우가 아닙니다.
- 2.3.2 설정을 그대로 썼습니다. 새 옵션과 InfinDIA 모드는 시험하지 않았습니다.
- 여기서 정확도는 알려진 혼합 비율과 맞는지를 뜻합니다. 동정 오류율을 직접 시험한 것은 아닙니다.