무작위 유전자 세트도 생존을 «예측»한다: TCGA로 재 보니 «최적 절단점»은 쓸모없는 지표의 절반 가까이를 유의하게 만들었다
TCGA 암종 4개에서 무작위 50유전자 세트 1,000개를 무진행 생존과 비교하고, 생존과 아무 관계 없는 지표를 시뮬레이션했습니다. «최적 절단점»을 고르고 그 log-rank p를 그대로 보고하면 쓸모없는 지표의 44~49%가 p < 0.05였습니다. 신장암에서는 무작위 세트의 57%가 예후 인자로 나왔고, 증식과 병기를 모델에 넣자 네 암종 모두 4~10%로 내려갔습니다.
아래 숫자는 정답을 아는 시뮬레이션과 공개 TCGA 데이터에서 나왔습니다. 스크립트, 출력, 그림은 공개되어 있고, CI가 시뮬레이션과 채점을 다시 돌려 숫자가 정확히 같은지 확인합니다. 글을 쓰기 전에 TCGA 파일을 다시 받아(md5 일치) 우리 서버에서 더 새 패키지(survival 3.7.0, maxstat 0.7.26)로 처음부터 돌렸는데, p값 표가 바이트 단위까지 같았습니다. 17,608줄, p값 104,040개입니다. 고객 데이터는 쓰지 않았습니다. (English version: Random gene signatures 'predict' survival in TCGA)
두 곡선이 벌어지고 구석에 «p = 0.003»이 찍힌 Kaplan-Meier 그림은 예후 바이오마커를 소개하는 가장 흔한 방법입니다. «높음»과 «낮음»을 나눈 기준을 같은 데이터에서 골랐다면 이 그림을 얼마나 믿어도 되는지, 그리고 유전자를 아무렇게나 뽑아 만든 시그니처가 얼마나 자주 예후 인자처럼 보이는지 재 봤습니다.
결과부터 말하면, «최적» 절단점을 고르고 그 나누기의 p값을 찍으면 생존과 아무 관계 없는 지표의 44~49%가 유의하게 나왔습니다. TCGA 신장암에서는 무작위 50유전자 시그니처의 57%가 평범한 Cox 모델에서 무진행 생존과 관련 있게 나왔습니다. 증식과 병기를 보정하면 대부분 사라지지만 전부는 아니었습니다.
«최적» 나누기는 보통 이렇게 만든다
library(survival); library(survminer)
cut <- surv_cutpoint(d, time = "time", event = "event", variables = "score")  # 가장 좋은 나누기를 찾는다
d2  <- surv_categorize(cut)
fit <- survfit(Surv(time, event) ~ score, data = d2)
ggsurvplot(fit, data = d2, pval = TRUE)   # 고른 나누기의 log-rank p를 붙인다
surv_cutpoint는 점수의 10번째와 90번째 백분위 사이 모든 나누기를 시험하고, 표준화한 log-rank 통계량이 가장 큰 것을 남깁니다. 그림에는 그 나누기 하나의 p값이 다른 나누기는 본 적 없는 것처럼 찍힙니다. 그림만 봐서는 탐색을 했는지 알 수 없습니다.
오래된 문제가 하나 더 있습니다. Venet 등은 2011년에 유방암에서 무작위 유전자 세트 대부분이 예후와 관련 있게 나온다는 것을 보였습니다. 증식과 함께 움직이는 유전자가 워낙 많기 때문입니다. 지금의 TCGA에서, 유방암 말고 다른 암에서도 그런지 확인했습니다.
무엇을 돌렸나
시뮬레이션에서는 지표와 생존 시간을 서로 독립으로 뽑았습니다. 지수 분포 생존에 균일 중도 절단이고, 환자의 약 37%에서 사건이 생깁니다. n = 100, 300, 1,000에서 각각 1,000번 반복했습니다. 실제 효과가 있는 두 경우로 검정력도 쟀습니다. 선형 효과(표준편차당 위험비 1.25)와 문턱 효과(상위 4분의 1에서 위험비 2, 사건 42%)입니다.
TCGA 발현은 UCSC Xena(유전자 단위 RSEM, log2(정규화 count + 1), 20,530개 유전자)에서 받았고, 유전자마다 암종 안에서 z 점수로 바꿨습니다. 생존과 병기는 TCGA Pan-Cancer Clinical Data Resource(Liu 등 2018)를 썼습니다. 종점은 무진행 기간(PFI)입니다. 유방암은 TCGA 추적 기간 안의 사망이 너무 적어 전체 생존을 쓰기 어렵습니다. 원발 종양만 넣었습니다.
| 암종 | 환자 | PFI 사건 |
|---|---|---|
| BRCA | 1,081 | 145 |
| KIRC | 529 | 159 |
| LUAD | 502 | 206 |
| COAD | 278 | 81 |
시그니처 점수는 들어 있는 유전자의 z 점수 평균이고, 네 종류를 매겼습니다.
- 발현되는 모든 유전자에서 뽑은 무작위 50유전자 세트 1,000개
- 증식과 거의 상관없는 유전자(|r| < 0.2)에서만 뽑은 무작위 50유전자 세트 1,000개
- PAM50 증식 시그니처 11개 유전자(BIRC5, CCNB1, CDC20, NUF2, CEP55, NDC80, MKI67, PTTG1, RRM2, TYMS, UBE2C)
- 그 증식 점수와 상관이 가장 높은 50개 유전자(11개 제외). Venet의 meta-PCNA 대신 썼습니다.
실제 생존 정보로는 시그니처 하나하나에 정답이 없습니다. 그래서 모든 분석을 생존 시간과 사건을 환자 사이에서 함께 섞은 상태로도 돌렸습니다. 생존 정보를 섞으면 어떤 지표도 생존과 관련이 있을 수 없어서, p < 0.05는 모두 가짜 양성입니다.
지표마다 같은 분석을 거쳤습니다.
| 분석 | 보고하는 값 |
|---|---|
| Cox, 연속 점수 | 점수의 Wald p |
| 중앙값 나누기 | 중앙값에서 높음과 낮음으로 나눈 log-rank p |
| 최적 절단점, 보정 안 한 p | 10~90번째 백분위 사이에서 가장 좋은 나누기(surv_cutpoint의 탐색)를 고른 뒤, 미리 정한 것처럼 계산한 log-rank p |
| 최적 절단점, 보정한 p | 같은 탐색을 하고, 최대 선택 통계량의 p값(maxstat, Lausen과 Schumacher 1992) |
| Cox, 보정 | 점수에 증식 점수를 더하고, 이어서 AJCC 병기도 더함(병기를 아는 환자만) |
생존과 아무 관계 없는 지표
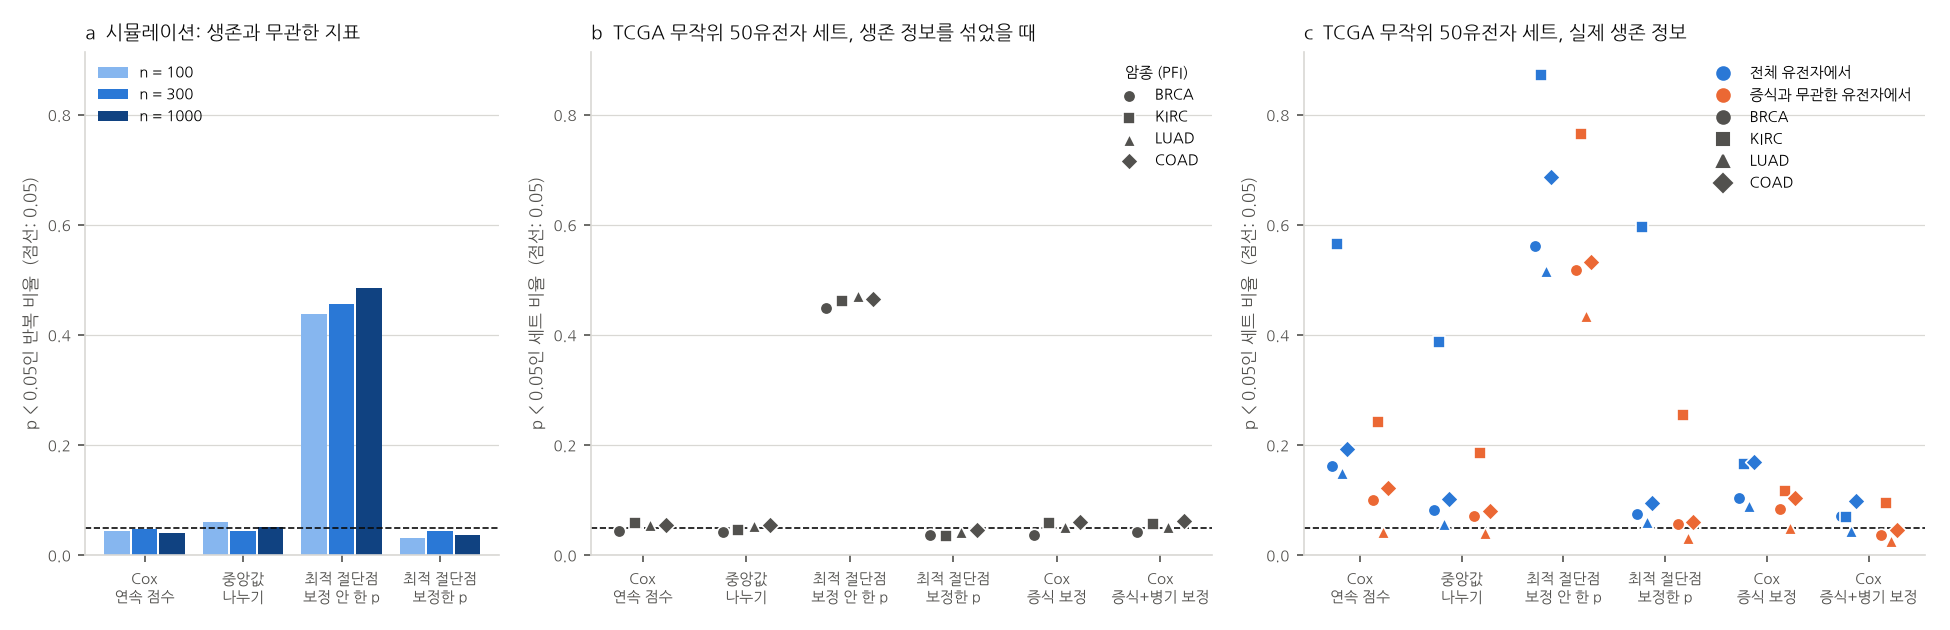
시뮬레이션 1,000번 중 p < 0.05인 비율입니다. 신호가 없으면 목표는 0.05입니다.
| n | Cox 연속 점수 | 중앙값 나누기 | 최적 절단점, 보정 안 한 p | 최적 절단점, 보정한 p |
|---|---|---|---|---|
| 100 | 0.044 | 0.060 | 0.439 | 0.032 |
| 300 | 0.048 | 0.044 | 0.457 | 0.044 |
| 1,000 | 0.040 | 0.052 | 0.486 | 0.036 |
보정 안 한 p는 표본이 커질수록 0.44에서 0.49로 조금씩 올라갑니다. 표본이 크면 탐색할 여지가 넓어진다는 설명과 맞습니다. 다만 반복 1,000번의 표준오차가 1.6%포인트쯤이라 n = 100과 300은 사실상 구분되지 않습니다.
고른 나누기는 효과 크기도 부풀립니다. 여기서 위험비는 1 이상이 되도록 뒤집어 보고했기 때문에, 효과가 없어도 1보다 조금 큰 값이 나옵니다. 같은 척도에서 생존과 무관한 지표를 중앙값으로 나누면 n = 300에서 위험비 중앙값이 1.14였고, 최적 나누기는 1.56이었습니다. n = 100에서는 1.26과 2.13이었습니다.
보정한 p는 제대로 움직였습니다. 신호가 없을 때 3.2~4.4%입니다. 대가도 있습니다. 선형 효과에서는 Cox 모델보다 검정력이 낮았고(n = 300에서 0.47, Cox는 0.65), 효과에 실제로 문턱이 있을 때는 오히려 나았습니다(0.83, Cox는 0.75).
생존 정보를 섞은 TCGA
생존 정보를 섞으면 전체 유전자에서 뽑은 무작위 세트의 p < 0.05가 한 가지 분석만 빼고 모두 3.56.2%였습니다. 보정 안 한 최적 절단점은 네 암종 모두 4547%였습니다. 실제 발현 데이터도 시뮬레이션과 똑같이 움직였습니다.
실제 생존 정보의 TCGA
무작위 50유전자 세트(전체 유전자) 1,000개 중 p < 0.05인 비율입니다.
| 암종 | Cox 연속 점수 | 중앙값 나누기 | 최적 절단점, 보정 안 한 p | 최적 절단점, 보정한 p | Cox, 증식 보정 | Cox, 증식+병기 보정 |
|---|---|---|---|---|---|---|
| BRCA | 0.162 | 0.082 | 0.561 | 0.075 | 0.104 | 0.071 |
| KIRC | 0.565 | 0.388 | 0.872 | 0.597 | 0.165 | 0.070 |
| LUAD | 0.150 | 0.056 | 0.517 | 0.061 | 0.089 | 0.044 |
| COAD | 0.193 | 0.102 | 0.687 | 0.095 | 0.170 | 0.099 |
신장암에서는 무작위 50유전자 세트의 절반 넘는 세트가 평범한 Cox 모델에서 예후 인자로 나왔고, 보정 안 한 최적 절단점으로는 87%였습니다.
증식과 상관없는 유전자에서만 뽑은 세트는 덜 나왔습니다. KIRC 24%(전체 유전자는 57%), BRCA 10%, LUAD 4%, COAD 12%입니다. 증식 시그니처 자체는 KIRC에서 아주 강하게 예후와 관련됐고(p = 4.4 × 10⁻¹⁷), LUAD(0.0026)와 BRCA(0.031)에서는 그보다 약했으며, COAD에서는 관련이 없었습니다(0.49). KIRC에서 증식과 상관이 가장 높은 50개 유전자는 증식 점수를 모델에 넣자 p = 1.8 × 10⁻¹⁵에서 0.26이 됐습니다.
대장암은 다르게 움직였습니다. 증식 점수가 예후 인자가 아니고, 증식을 보정해도 무작위 세트는 거의 그대로였습니다(19.3%에서 17.0%). 9.9%까지 내려간 것은 대부분 병기 몫입니다. 그래도 9.9%는 같은 분석을 생존 정보를 섞어 돌린 값(6.2%)의 두 배 가까이라, 다른 무언가가 신호를 싣고 있습니다. 대장암에서는 기질 비율이 알려진 후보인데, 여기서는 시험하지 않았습니다.
숫자를 보고 든 생각
더 큰 문제는 절단점입니다. 생물학이 아니라 통계의 오류라서, 우리가 해 본 모든 데이터에서 시뮬레이션이든 실제든 쓸모없는 지표의 절반 가까이를 유의하게 만들었습니다.
무작위 시그니처가 예후와 관련 있게 나오는 것은 반대로 실제 생물학을 반영합니다. 증식과 병기는 결과와 강하게 묶여 있고, 많은 유전자가 그 둘을 따라 움직입니다. 그러면 새 시그니처가 보여 줘야 할 것도 달라집니다. 신장암에서는 생존과 관련 있다는 것만으로 부족합니다. 무작위 유전자 세트의 절반 넘는 세트가 이미 그렇기 때문입니다. p = 0.01이 찍힌 Kaplan-Meier 그림은 그 시그니처가 이 기본값을 넘었는지 말해 주지 않습니다.
대신 이렇게
주 검정은 Cox 모델에 연속 점수로 하고, 나누기는 그림에만 쓰세요. 데이터로 절단점을 골라야 한다면 찾아낸 나누기의 p가 아니라 탐색을 감안한 p를 보고하세요.
library(survival); library(maxstat)
mt <- maxstat.test(Surv(time, event) ~ score, data = d, smethod = "LogRank",
                   pmethod = "Lau92", minprop = 0.1, maxprop = 0.9)
mt$estimate   # 고른 절단점
mt$p.value    # 탐색을 감안한 p값
한 코호트에서 절단점을 정하고 다른 코호트에서 검정하면 더 좋습니다. 시그니처를 예후 인자라고 부르기 전에 같은 데이터에서 같은 크기의 무작위 시그니처를 몇백 개 매겨 보고, 내 시그니처가 그중 어디에 있는지 보세요. 그리고 이미 알려진 예후 인자(증식, 병기, 등급)를 모델에 먼저 넣은 다음에 시그니처가 무언가를 더하는지 말하세요.
한계
TCGA 암종 4개와 종점 하나(무진행 기간)입니다. 전체 생존이나 다른 암종에서는 비율이 다를 수 있지만, 절단점 편향의 방향은 데이터와 상관없습니다. 시그니처 크기는 50개 유전자 하나, 점수 계산은 z 점수 평균 하나만 썼습니다. 병기 보정 모델은 병기를 아는 환자만 씁니다(예를 들어 BRCA 1,081명 중 1,057명, COAD 278명 중 268명). BRCA는 4기 환자가 20명뿐이라 일부 보정 모델에서 병기 계수가 발산한다는 경고가 나오는데, 점수의 p값에는 영향이 없습니다. 시뮬레이션은 지수 분포 생존과 균일 중도 절단이라 실제 추적 자료보다 깔끔합니다.
재현
모든 파일은 sbmlab-benchmarks/random-signatures-tcga에 있습니다. bash download.sh가 UCSC Xena에서 약 150MB를 받습니다. 시뮬레이션은 1분 안쪽, TCGA 부분은 코어 하나로 6~7분 걸립니다(R 4.3.3, survival, maxstat, data.table). 다른 Xena 암종도 이름만 넘기면 됩니다.
참고 문헌
- Venet D, Dumont JE, Detours V. Most random gene expression signatures are significantly associated with breast cancer outcome. PLoS Comput Biol 2011;7(10):e1002240.
- Altman DG, Lausen B, Sauerbrei W, Schumacher M. Dangers of using "optimal" cutpoints in the evaluation of prognostic factors. J Natl Cancer Inst 1994;86(11):829-835.
- Lausen B, Schumacher M. Maximally selected rank statistics. Biometrics 1992;48(1):73-85.
- Liu J, et al. An integrated TCGA pan-cancer clinical data resource to drive high-quality survival outcome analytics. Cell 2018;173(2):400-416.
- Nielsen TO, et al. A comparison of PAM50 intrinsic subtyping with immunohistochemistry and clinical prognostic factors in tamoxifen-treated estrogen receptor-positive breast cancer. Clin Cancer Res 2010;16(21):5222-5232.
함께 읽을 글
관련 글
배치 보정하고 검정하면 괜찮을까? 그룹이 배치에 고르지 않으면 ComBat이 목표 5%인 가짜 양성을 29%로 만든다
11월 4일 · 16 min read
Bioinformatics바이오마커 DB에 시맨틱 검색을 붙이며 배운 것 — 임베딩 1,141개, pgvector, 그리고 시드 데이터
10월 11일 · 22 min read
바이오인포매틱스bcftools와 GATK HaplotypeCaller를 GIAB HG002 정답으로 채점했습니다: SNP는 동점, 인델은 차이가 컸고 하드 필터는 진짜 변이를 지웠습니다
11월 14일 · 13 min read
바이오인포매틱스환자 그룹 사이 단일세포 차등발현: 차이가 없어도 세포 단위 검정은 유전자의 최대 24%를 잡아냅니다. 실제 공여자로 잰 pseudobulk와 FindMarkers
11월 9일 · 15 min read