bcftools와 GATK HaplotypeCaller를 GIAB HG002 정답으로 채점했습니다: SNP는 동점, 인델은 차이가 컸고 하드 필터는 진짜 변이를 지웠습니다
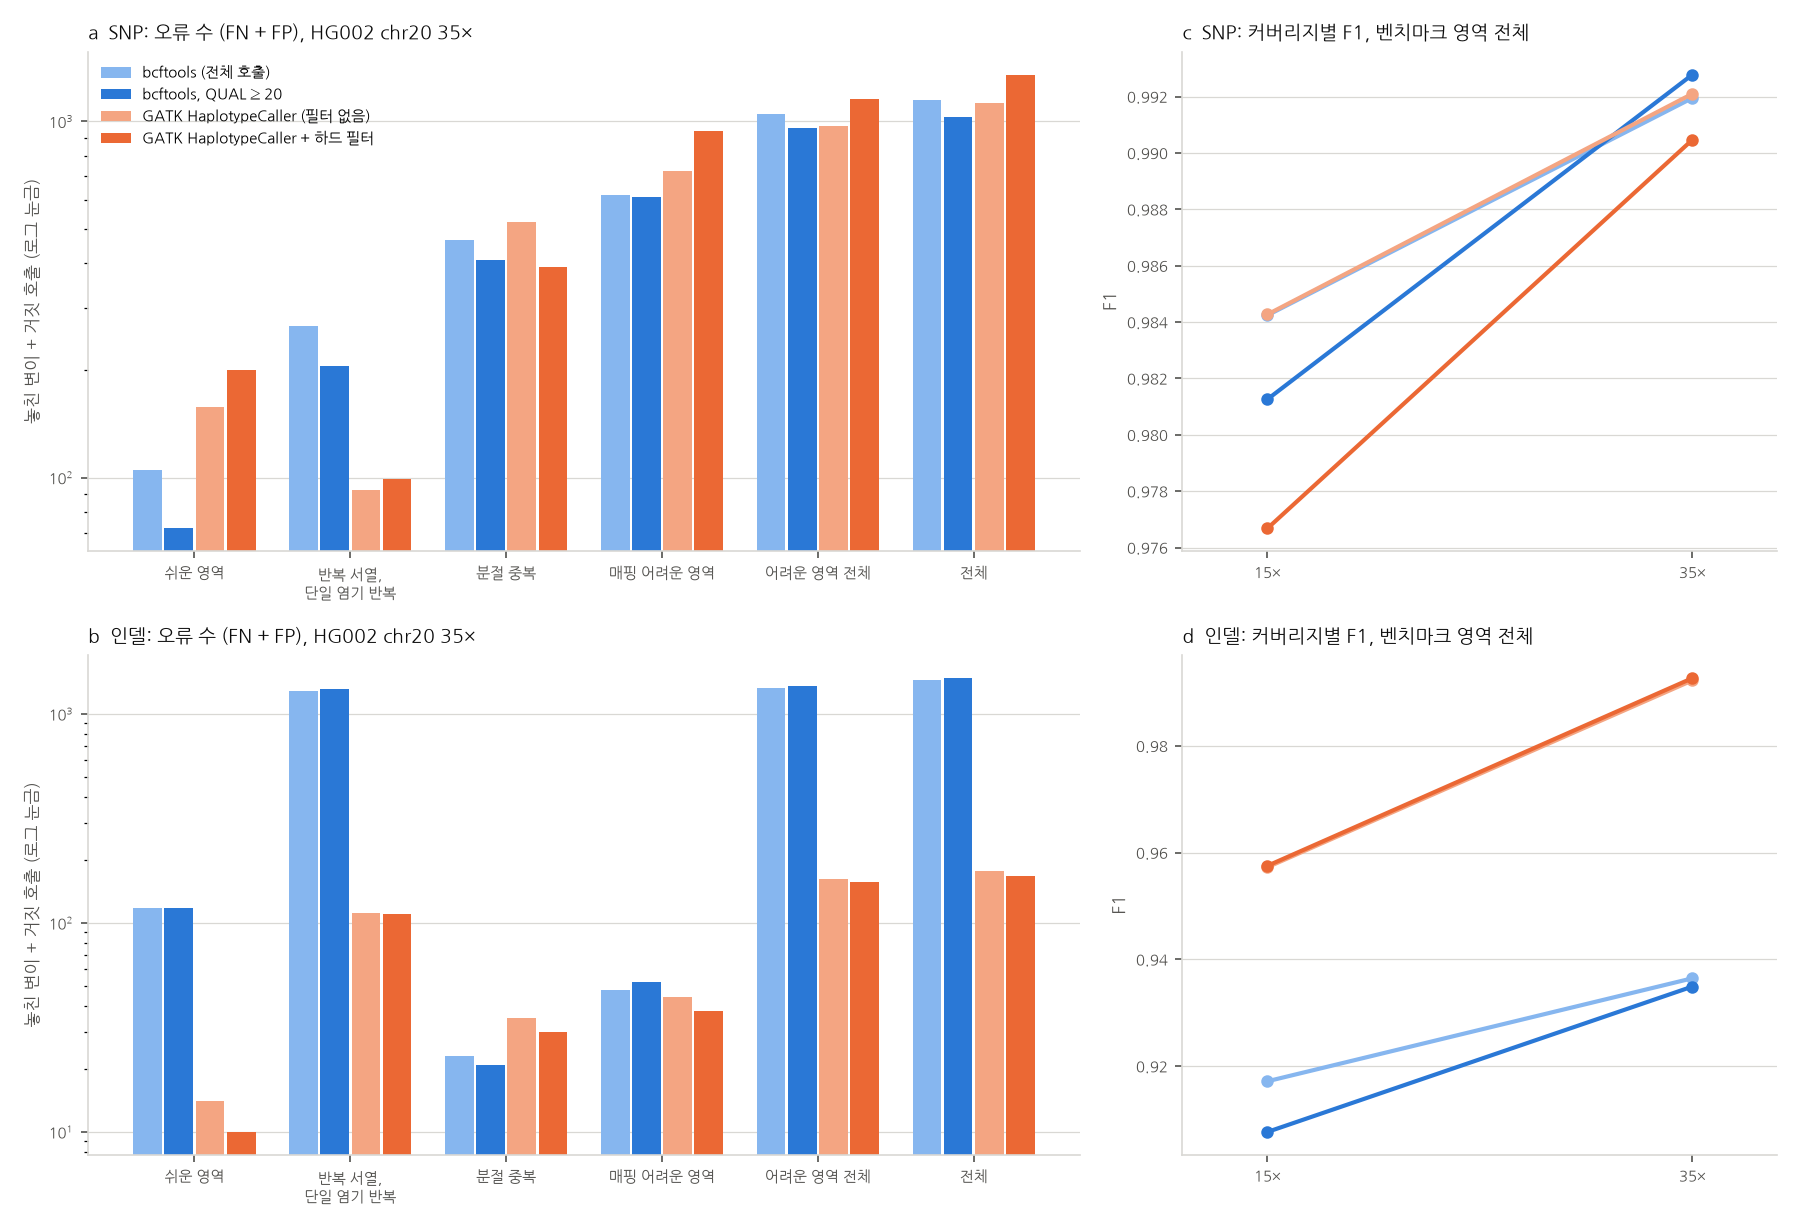
GIAB HG002 20번 염색체에서 bcftools와 GATK HaplotypeCaller로 생식세포 변이를 부르고, hap.py로 GIAB v4.2.1 정답과 비교했습니다. SNP는 둘 다 F1 0.992로 같았습니다. 인델은 GATK가 0.992, bcftools가 0.937이었고, bcftools의 거짓 인델은 대부분 대립유전자는 맞고 유전자형이 틀린 경우였습니다. GATK 권장 하드 필터는 진짜 SNP 580개를 지웠고, 대부분 매핑이 어려운 영역에 있었습니다.
아래 숫자는 모두 공개 정답 세트로 채점했습니다. 실행 스크립트, 정리한 hap.py 표, 채점 스크립트, 그림은 공개되어 있고, CI가 채점을 다시 돌려 숫자가 정확히 같은지 확인합니다. 처음 실행은 4코어 클라우드 컨테이너에서 했습니다. 글을 쓰기 전에 입력 파일을 다시 받아(md5 일치) 같은 도구 버전으로 우리 서버에서 모든 단계를 다시 돌렸는데, hap.py 표 4개가 바이트 단위까지 같았습니다. 고객 데이터는 쓰지 않았습니다. (English version: bcftools vs GATK HaplotypeCaller, scored against GIAB HG002)
생식세포 변이 호출 도구를 고르거나, 지금 파이프라인에 들어 있는 도구가 쓸 만한지 궁금하다면 변이를 이미 아는 시료와 비교하는 것이 가장 쓸모 있습니다. Genome in a Bottle(GIAB)이 HG002 시료의 정답을 바로 그렇게 공개합니다. 그래서 HG002의 공개 정렬 파일 하나를 가져와, GPU나 클러스터 없이 가장 많이 쓰는 두 도구인 bcftools와 GATK HaplotypeCaller를 돌렸습니다.
단일 염기 변이(SNP)에서는 둘이 같았습니다. 인델은 달랐습니다. bcftools는 진짜 인델을 GATK보다 8배 많이 놓쳤고, 유전자형도 훨씬 많이 틀렸습니다. 많은 파이프라인이 기본으로 거는 GATK 권장 하드 필터는 거짓 SNP보다 진짜 SNP를 더 많이 지웠습니다.
무엇을 돌렸나
입력은 HG002(NA24385) Illumina NovaSeq PCR-free 전장 유전체 35× 데이터입니다. BWA-MEM으로 GRCh38(no-alt)에 정렬하고 중복 읽기를 표시한 파일로, Google이 DeepVariant 사례 연구에 쓰는 BAM을 20번 염색체만 잘라 둔 파일입니다. 같은 BAM을 다운샘플링해 15× 판도 만들었습니다.
모든 도구가 같은 정렬 파일을 읽었으니, 정렬기가 아니라 변이 호출기만 비교합니다.
| 호출 세트 | 실행 방법 |
|---|---|
| bcftools, 전체 호출 | bcftools 1.25: mpileup -q 20 -Q 20 -d 250 -a AD,DP 출력을 call -mv로 넘김 |
| bcftools, QUAL ≥ 20 | 같은 호출에서 LowQual 표시가 붙은 것을 뺌 |
| GATK HaplotypeCaller | GATK 4.6.2.0 기본 설정. chr20을 네 조각으로 나눠 병렬로 돌리고 합침 |
| GATK + 하드 필터 | GATK 권장 하드 필터. SNP: QD < 2, FS > 60, MQ < 40, MQRankSum < −12.5, ReadPosRankSum < −8, SOR > 3. 인델: QD < 2, FS > 200, ReadPosRankSum < −20, SOR > 10. 가이드의 QUAL < 30은 뺐습니다. HaplotypeCaller는 기본 설정에서 QUAL 30 미만을 내보내지 않습니다 |
VQSR은 돌리지 않았습니다. 시료 하나의 염색체 하나보다 훨씬 많은 변이가 있어야 하기 때문입니다. DeepVariant는 이번에 빠졌고, 나중에 더할 계획입니다.
채점은 hap.py 0.3.15(vcfeval 엔진)로 HG002의 GIAB v4.2.1 벤치마크와 비교했습니다. 벤치마크 영역 안만 셉니다. chr20에서 이 영역은 57.0 Mb이고, 정답 SNP 71,333개와 정답 인델 11,256개가 들어 있습니다. hap.py는 GIAB v3.3의 «어려운 영역» 층별로도 따로 점수를 냅니다. 반복 서열과 단일 염기 반복, 분절 중복, 매핑이 어려운 영역입니다.
35× 결과
| 호출 세트 | SNP 재현율 | SNP 정밀도 | SNP F1 | 인델 재현율 | 인델 정밀도 | 인델 F1 |
|---|---|---|---|---|---|---|
| bcftools, 전체 호출 | 0.994 | 0.990 | 0.9920 | 0.931 | 0.942 | 0.9365 |
| bcftools, QUAL ≥ 20 | 0.993 | 0.992 | 0.9928 | 0.925 | 0.945 | 0.9349 |
| GATK HaplotypeCaller | 0.994 | 0.990 | 0.9921 | 0.991 | 0.993 | 0.9923 |
| GATK + 하드 필터 | 0.986 | 0.995 | 0.9905 | 0.991 | 0.994 | 0.9927 |
SNP는 동점입니다. 두 도구 모두 정답 SNP 71,333개 가운데 430개쯤 놓쳤고(bcftools 437, GATK 424), 거짓 호출은 710개쯤이었습니다(714, 705). 어려운 영역을 모두 뺀 곳에서는 둘 다 SNP F1이 0.999였습니다.
인델은 다릅니다. 정답 인델 11,256개 가운데 bcftools는 781개를, GATK는 97개를 놓쳤습니다. bcftools의 거짓 인델 호출 675개 가운데 592개는 대립유전자는 맞고 유전자형이 틀렸습니다. 대개 이형접합을 동형접합으로 부르거나 그 반대였습니다. GATK의 거짓 인델 호출은 모두 합쳐 80개였습니다. 대립유전자를 찾았는지만 보는 비교였다면 bcftools 점수가 이 글보다 훨씬 높게 나왔을 겁니다.
하드 필터는 정밀도를 올리고 재현율을 깎습니다. SNP에서 GATK 필터는 거짓 호출 356개를 지웠지만 진짜 호출 580개도 함께 지웠습니다. 그래서 F1이 0.9921에서 0.9905로 내려갔습니다. 잃은 진짜 SNP는 대부분(580개 중 413개) 매핑이 어려운 영역에 있었고, 그곳 SNP 재현율은 0.867에서 0.715로 떨어졌습니다. 580개 가운데 MQ < 40에 걸린 것이 382개, SOR > 3에 걸린 것이 211개였습니다(둘 다 걸린 호출도 있습니다). 매핑이 어려운 영역의 읽기는 매핑 품질이 낮은 경우가 많습니다. 인델에서는 필터가 조금 도움이 됐습니다(F1 0.9923에서 0.9927).
어디서 틀리나
35×에서 영역별 SNP, 인델 F1:
| 호출 세트 | 쉬운 영역 | 어려운 영역 전체 | 반복 서열, 단일 염기 반복 | 분절 중복 | 매핑 어려운 영역 |
|---|---|---|---|---|---|
| SNP, bcftools | 0.9991 | 0.953 | 0.968 | 0.860 | 0.883 |
| SNP, GATK | 0.9987 | 0.956 | 0.989 | 0.846 | 0.867 |
| SNP, GATK + 필터 | 0.9983 | 0.946 | 0.988 | 0.877 | 0.805 |
| 인델, bcftools | 0.983 | 0.917 | 0.916 | 0.919 | 0.830 |
| 인델, GATK | 0.998 | 0.990 | 0.993 | 0.889 | 0.862 |
| 인델, GATK + 필터 | 0.999 | 0.990 | 0.993 | 0.903 | 0.878 |
SNP에서는 모든 호출 세트가 분절 중복과 매핑 어려운 영역에서 가장 나빴고, 그곳 F1은 0.810.88까지 내려갔습니다. 분절 중복에서는 주로 거짓 양성이 문제였습니다. 그곳 SNP 정밀도는 재현율 0.920.95에서 0.77~0.83이었습니다. 유전체 다른 곳에 있는 거의 같은 사본의 읽기가 이 자리에 정렬되기 때문일 가능성이 큽니다. 반복 서열과 단일 염기 반복에서는 GATK가 확실히 나았습니다(SNP F1 0.989 대 0.968, 인델 F1 0.993 대 0.916). GATK의 국소 재조립은 이런 영역을 겨냥해 만든 방식입니다.
15×에서는
| 호출 세트 | SNP F1 | 인델 F1 |
|---|---|---|
| bcftools, 전체 호출 | 0.9842 | 0.9172 |
| bcftools, QUAL ≥ 20 | 0.9813 | 0.9077 |
| GATK HaplotypeCaller | 0.9843 | 0.9573 |
| GATK + 하드 필터 | 0.9767 | 0.9575 |
커버리지가 낮아지면 두 도구가 SNP를 같은 비율로 잃고, 인델 격차는 그대로이며, 필터의 손해가 커집니다. 하드 필터와 QUAL ≥ 20 기준은 흔한 커버리지에 맞춰 만든 것이라, 15×에서는 진짜 호출을 더 많은 비율로 지웁니다(GATK SNP 재현율 필터 전 0.982, 필터 후 0.965).
실행 시간
chr20을 스레드 4개로 돌렸을 때 bcftools는 35×에서 3.7분(메모리 107 MB)이 걸렸습니다. GATK는 실제 시간 17.4분, CPU 시간 58분이었습니다(프로세스당 3.1 GB). bcftools mpileup은 스레드 하나로만 돌고, --threads는 압축만 빠르게 합니다. 이 시간은 클라우드 실행에서 쟀습니다. 우리 서버의 재실행은 단백체 검색 두 개와 함께 돌아서 시간을 비교할 수 없습니다. 시간은 더 걸렸고 결과는 같았습니다.
이 결과로 무엇을 할까
다루기 쉬운 영역의 SNP라면 어느 도구든 괜찮고, bcftools가 몇 배 저렴합니다. 인델이 중요한 일이라면 GATK HaplotypeCaller가 더 안전한 기본값입니다. 차이의 상당 부분이 유전자형에 있으니, 파이프라인을 검증할 때는 대립유전자가 있는지만 보지 말고 유전자형 일치까지 확인하세요. 하드 필터는 기본값으로 두기보다 시험해 볼 대상으로 보세요. 이 시료에서는 필터가 SNP 결과를 나쁘게 만들었고, 손해는 원래 호출을 가장 믿기 어려운 영역에 몰렸습니다. 어떤 도구를 쓰든 분절 중복과 매핑 어려운 영역에서 나온 결과는 그것으로 무언가를 결정하기 전에 한 번 더 보세요.
한계
시료 하나, 염색체 하나, 라이브러리 종류 하나(NovaSeq PCR-free)입니다. PCR로 증폭한 라이브러리는 인델 오류가 훨씬 많고, 그 오류는 주로 단일 염기 반복에서 나옵니다(Fang 외 2014). 그래서 이 글의 인델 숫자는 좋은 조건에서 나온 값입니다. GATK는 네 조각으로 나눠 돌린 뒤 합쳤습니다. 조각 경계 세 곳의 앞뒤 300 bp를 확인했고, 그 안의 정답 변이 8개는 모두 한 번씩 호출됐습니다. VQSR과 공동 유전자형 분석은 하지 않았고, DeepVariant는 아직입니다.
직접 재현하기
내려받기 스크립트, 실행 스크립트(bcftools, GATK, DeepVariant, hap.py 단계), 정리한 hap.py 표, 점수, 그림: sbmlab-benchmarks/variant-calling-giab. download.sh는 2.2 GB쯤 받습니다. 도구는 bioconda에서 설치합니다(gatk4 4.6.2.0, bcftools 1.25, samtools 1.25, hap.py 0.3.15, rtg-tools 3.13).
참고 문헌
- Wagner J, et al. Benchmarking challenging small variants with linked and long reads. Cell Genomics 2022;2(5):100128. (GIAB v4.2.1)
- Krusche P, et al. Best practices for benchmarking germline small-variant calls in human genomes. Nat Biotechnol 2019;37:555-560. (hap.py)
- Danecek P, et al. Twelve years of SAMtools and BCFtools. GigaScience 2021;10(2):giab008.
- Poplin R, et al. Scaling accurate genetic variant discovery to tens of thousands of samples. bioRxiv 2017:201178. (GATK HaplotypeCaller)
- Fang H, et al. Reducing INDEL calling errors in whole genome and exome sequencing data. Genome Med 2014;6:89.
함께 보기
관련 글
1% FDR은 정말 1%인가: MaxQuant, FragPipe, DIA-NN 검색에 애기장대 단백질 14,567개를 숨겨 봤습니다
11월 14일 · 22 min read
프로테오믹스DIA-NN 2.7.0 업그레이드: 정답 아는 데이터로 2.3.2와 비교해 보니
11월 1일 · 20 min read
바이오인포매틱스무작위 유전자 세트도 생존을 «예측»한다: TCGA로 재 보니 «최적 절단점»은 쓸모없는 지표의 절반 가까이를 유의하게 만들었다
11월 13일 · 17 min read
바이오인포매틱스환자 그룹 사이 단일세포 차등발현: 차이가 없어도 세포 단위 검정은 유전자의 최대 24%를 잡아냅니다. 실제 공여자로 잰 pseudobulk와 FindMarkers
11월 9일 · 15 min read