1% FDR은 정말 1%인가: MaxQuant, FragPipe, DIA-NN 검색에 애기장대 단백질 14,567개를 숨겨 봤습니다
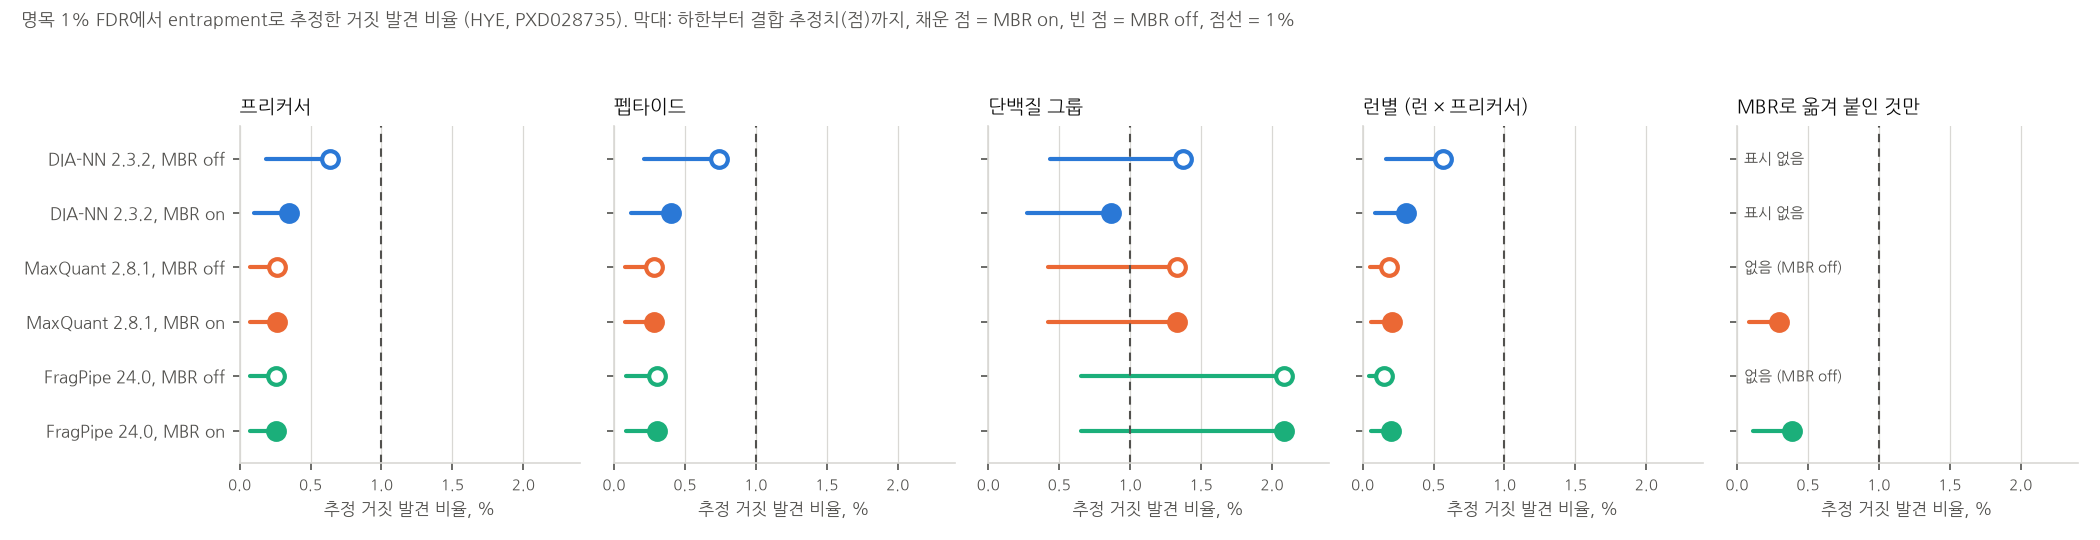
같은 사람, 효모, 대장균 혼합 시료를 검색할 때 시료에 있을 수 없는 애기장대 단백체를 DB에 섞고, MaxQuant 2.8.1, FragPipe 24, DIA-NN 2.3.2가 1% FDR에서 그것을 얼마나 보고하는지 셌습니다. 프리커서와 펩타이드는 1% 안에 넉넉히 들어왔습니다. 단백질 그룹은 달랐습니다. 추정치가 FragPipe 2.09%, MaxQuant 1.33%, MBR 없는 DIA-NN 1.37%였습니다. MBR로 옮겨 붙인 식별은 오류를 거의 늘리지 않았습니다.
아래 검색은 모두 공개 데이터로 제 워크스테이션에서 돌렸습니다. 집계, 채점 스크립트, 그림은 공개되어 있고, CI가 함께 올린 집계로 채점을 다시 돌려 숫자가 바이트 단위까지 같은지 확인합니다. 고객 데이터는 쓰지 않았습니다. (English version: Is 1% FDR really 1%?)
정답을 아는 공개 데이터로 단백체 소프트웨어를 직접 돌려 보는 시리즈의 네 번째 글입니다. 앞의 글들은 정량을 채점했습니다. MaxQuant 2.8, FragPipe와 MaxQuant, DIA-NN과 두 도구 비교입니다(모두 영문). 이번에는 그 글들이 당연하게 여긴 질문을 확인합니다. 검색 엔진이 「1% FDR로 걸렀다」고 하면, 목록에서 실제로 틀린 식별이 1% 안팎일까요?
이 1%를 정하는 target-decoy 방식(Elias와 Gygi 2007)은 스스로를 검증하지 못합니다. decoy가 잣대이므로, decoy와 진짜 거짓 식별을 다르게 다루는 도구라도 자신 있게 1%를 보고합니다. 독립적으로 확인하려면 도구가 정체를 모르는 거짓 식별이 필요합니다.
방법: 있을 수 없는 단백질을 섞는다
시료는 앞 글들과 같은 세 종 혼합물입니다. PRIDE PXD028735(Van Puyvelde 외 2022)로, 사람, 효모, 대장균 단백질 분해물을 정해진 비율로 섞었습니다. Swiss-Prot 단백질 31,695개로 된 DB에 애기장대(Arabidopsis thaliana) Swiss-Prot 단백체를 더했습니다. 식물 단백체는 이 혼합물에 들어 있을 수 없으니, 애기장대 식별은 모두 거짓입니다. 먼저 표적 단백질과 트립신 펩타이드를 하나라도 공유하는 애기장대 단백질 1,854개(히스톤, 유비퀴틴, 액틴 등)를 뺐습니다. 그래서 entrapment 단백질은 14,567개가 남았고, 표적과 겹치는 완전한 트립신 펩타이드는 하나도 없습니다. FASTA 헤더에는 어느 단백질이 어느 쪽인지 알려 주는 표시가 없습니다.
entrapment 식별만 세서는 부족합니다. 거짓 식별은 진짜 단백질에도 떨어지기 때문입니다. Wen 외(2025)를 따라 목록마다 숫자 두 개를 냅니다. 표적 식별이 N_T개, entrapment 식별이 N_E개일 때 하한 N_E / (N_T + N_E)는 entrapment 식별만 거짓이라고 가정합니다. 결합 추정치 N_E (1 + 1/r) / (N_T + N_E)는 표적 쪽에 섞였을 거짓 식별까지 셉니다. r은 표적 대비 entrapment의 크기로, 여기서는 펩타이드 0.41, 단백질 0.46이었습니다. 그래서 entrapment 식별 하나가 거짓 식별 세 개에서 세 개 반을 대표합니다. Wen 외는 결합 추정치를 「추정 상한」이라고 부릅니다. 평균적으로 실제보다 높게 나옵니다. 하한이 1%를 넘으면 그 목록은 확실히 1% 넘게 틀렸고, Wen 외는 이를 FDR 관리 실패의 근거로 봅니다. 결합 추정치만 1%를 넘으면 경고입니다.
무엇을 돌렸나
DB만 빼고 모두 앞 글들과 같습니다.
| MaxQuant 2.8.1 | FragPipe 24.0 | DIA-NN 2.3.2 | |
|---|---|---|---|
| 런 | Orbitrap DDA 6개 | 같은 Orbitrap DDA 6개 | TripleTOF 6600+ SWATH 6개 |
| 설정 | MaxQuant 글과 같음 | LFQ-MBR 워크플로, FragPipe 글과 같음 | 라이브러리 없는 검색, DIA-NN 글과 같음 |
| 검색 | MBR on, MBR off | MBR on, MBR off | MBR on, MBR off |
| 스레드 | 16 | 8 | 24 |
| 실행 시간 | 10시간 40분, 5시간 42분 | 16.5분, 15분 | 10시간 57분, 3분 42초 |
엔진마다 표적만 넣은 검색도 따로 두어, DB가 커진 대가를 쟀습니다. DIA-NN의 MBR off 검색은 MBR on 검색의 1차 결과를 다시 써서 몇 분 만에 끝났습니다. 이 시간으로 속도를 비교하기는 어렵습니다. 첫 MaxQuant 검색과 DIA-NN 검색이 32코어 컴퓨터 한 대에서 동시에 돌았고, MaxQuant는 WSL에 연결한 Windows 드라이브에 썼습니다. 앞 글들에서 같은 런은 62분, 9분, 6시간 17분이 걸렸습니다.
MaxQuant와 FragPipe는 1% 필터를 통과한 것만 쓰므로 보고된 목록을 그대로 셌습니다. MaxQuant 단백질 그룹은 Q-value ≤ 0.01로도 잘랐는데 1% 목록에서 더 빠지는 것은 없었고, 변형 부위로만 찾은 그룹은 뺐습니다. DIA-NN은 q값을 보고하므로 0.01에서 잘랐습니다.
1%에서 결과
결합 추정치, 괄호 안은 하한입니다.
| 검색 | 프리커서 | 펩타이드 | 단백질 그룹 |
|---|---|---|---|
| DIA-NN, MBR off | 0.64% (0.18%) | 0.74% (0.21%) | 1.37% (0.43%) |
| DIA-NN, MBR on | 0.35% (0.10%) | 0.40% (0.12%) | 0.87% (0.27%) |
| MaxQuant, MBR off | 0.26% (0.08%) | 0.28% (0.08%) | 1.33% (0.42%) |
| MaxQuant, MBR on | 0.26% (0.08%) | 0.28% (0.08%) | 1.33% (0.42%) |
| FragPipe, MBR off | 0.26% (0.07%) | 0.30% (0.09%) | 2.09% (0.66%) |
| FragPipe, MBR on | 0.26% (0.07%) | 0.30% (0.09%) | 2.09% (0.66%) |
프리커서와 펩타이드 수준에서는 모든 엔진이 1% 안이고, 대부분 여유가 큽니다. MaxQuant는 표적 프리커서 48,943개와 entrapment 프리커서 37개를, FragPipe는 80,897개와 60개를 보고했습니다.
단백질 그룹은 다릅니다. FragPipe는 단백질 그룹 7,913개 가운데 애기장대 그룹 52개를, MaxQuant는 5,481개 가운데 23개를, MBR 없는 DIA-NN은 8,558개 가운데 37개를 보고했습니다. 결합 추정치로는 셋 다 1%를 넘고, FragPipe는 2배쯤입니다. 애기장대 entrapment에서는 하한이 어느 것도 1%에 이르지 않으니(아래 업데이트의 섞은 표적에서는 FragPipe가 달라집니다) 실패를 증명하지는 않습니다. Wen 외는 이런 결과를 「결론 없음」으로 봅니다. 실제 오류는 하한과 추정치 사이에 있고, entrapment 그룹이 2352개뿐이라 두 값 모두 흔들립니다(23개라는 숫자의 95% 범위는 대략 1535개입니다). 그래도 이 설정에서 「1% FDR」 단백질 목록은 1.3~2%까지 틀렸을 수 있습니다.
FragPipe에서는 먼저 떠오르는 설명 하나를 확인했지만 원인이 아니었습니다. FragPipe는 실험마다 단백질 목록을 쓰는데, 1% 목록 여섯 개를 합치면 하나보다 거짓 식별이 많아질 수 있습니다. 이번에는 합친 목록이 FragPipe의 통합 단백질 목록과 똑같았습니다(7,913개 그룹, 그중 애기장대 52개). Philosopher가 실험마다 같은 통합 단백질 추론 결과(combined.prot.xml)로 거르기 때문입니다. 2.09%는 그 목록 하나의 값입니다.
왜 펩타이드가 아니라 단백질일까요? 단백질 그룹은 펩타이드를 근거로 통과하는데, 여기서 거짓 그룹이 기댄 펩타이드는 아주 적었습니다. FragPipe의 애기장대 그룹 52개 중 47개, MaxQuant의 23개 중 19개가 펩타이드 하나였고, 세 개 이상인 그룹은 없었습니다. 단백질 수준 FDR은 도구마다 자기 가정으로 따로 계산하고, entrapment 추정이 가장 거친 곳도 여기입니다. 단백질 길이, 그룹 묶기, 최소 펩타이드 규칙이 모두 「거짓 식별은 r에 비례해 entrapment에 떨어진다」는 가정을 흔듭니다.
업데이트(2026-11-18): 두 번째 entrapment와 더 좁은 추정
위 결과에 나올 만한 반론은 entrapment 방식 하나에 기댄다는 점입니다. 그래서 여섯 검색을 Wen 외의 다른 방식으로 다시 돌렸습니다. 표적 단백질마다 섞은 사본을 하나씩 만들되, 트립신 펩타이드 안에서만 아미노산을 섞어 질량, 길이, 절단 위치는 그대로 두었습니다(entrapment 단백질 31,461개, 펩타이드 r = 1.04). 섞은 펩타이드마다 표적 쪽에 짝이 있어서, 이 방식에서는 Wen 외의 paired 추정치도 쓸 수 있습니다. 결합 추정치보다 좁은 상한입니다. 세 엔진 모두에 구현하고 정답을 아는 가짜 데이터로 검사 21개를 돌려 확인했습니다.
| 검색 | 펩타이드: paired (하한) | 단백질 그룹: paired (하한) |
|---|---|---|
| DIA-NN, MBR off | 0.58% (0.35%) | 1.02% (0.75%) |
| DIA-NN, MBR on | 0.32% (0.20%) | 0.93% (0.72%) |
| MaxQuant | 0.35% (0.17%) | 1.47% (0.89%) |
| FragPipe | 0.25% (0.15%) | 1.63% (1.11%) |
두 방식의 결과가 일치했습니다. entrapment 대 표적 비율이 2.5배 다른데도 펩타이드 수준 결합 추정치는 애기장대 결과와 거의 같았습니다. 단백질 수준은 더 분명해졌습니다. FragPipe의 하한이 1.11%로 1%를 넘어, 이 단백질 목록의 거짓 비율이 확실히 1%를 넘습니다(섞은 표적 식별은 모두 거짓). Wen 외 기준으로 FragPipe가 단백질 그룹 FDR을 관리하지 못한다는 근거입니다. MaxQuant도 1%를 넘을 가능성이 큽니다(paired 1.47%). DIA-NN은 MBR 없이 경계(1.02%)이고, MBR을 켜면 paired 추정 상한 0.93%로 지켜진다는 쪽의 근거가 됩니다. MBR로 옮겨 붙인 식별은 여전히 오류가 적었습니다(MaxQuant 59,899개 중 89개, FragPipe 79,736개 중 110개가 entrapment). 자료와 paired.py, 검사 코드는 벤치마크 폴더에 있습니다.
match-between-runs: 세는 방법의 함정
처음 집계에서는 MaxQuant의 MBR이 아무것도 바꾸지 않은 것처럼 나왔습니다. 켜든 끄든 모든 수준에서 숫자가 같았습니다. 알고 보니 MaxQuant가 아니라 세는 방법 때문이었습니다. MBR은 실험에 새 서열을 더하지 않습니다. 한 런에서 MS/MS로 찾은 프리커서를, MS/MS가 없던 다른 런으로 옮겨 붙입니다. 서열마다 실험 전체에서 한 번만 세면 이것이 보이지 않습니다.
그래서 런별 집계(런과 프리커서의 쌍 모두)와, 옮겨 붙인 것만 따로 세는 집계를 더했습니다. MaxQuant 2.8.1은 evidence.txt에서 옮겨 붙인 행의 Type을 비워 두고(옛 버전은 MULTI-MATCH), Match time difference를 채우고 MS/MS는 비웁니다. FragPipe는 combined_ion.tsv의 Match Type 열에 MBR로 표시합니다.
| 런별 식별 전체 | 옮겨 붙인 것만 | |
|---|---|---|
| MaxQuant, MBR off | 0.19% (187,074개 중 102개) | 없음 |
| MaxQuant, MBR on | 0.21% (240,783개 중 146개) | 0.30% (60,189개 중 52개) |
| FragPipe, MBR off | 0.15% (323,406개 중 144개) | 없음 |
| FragPipe, MBR on | 0.20% (401,633개 중 232개) | 0.39% (78,227개 중 88개) |
| DIA-NN, MBR off | 0.57% | 표시 없음 |
| DIA-NN, MBR on | 0.31% | 표시 없음 |
옮겨 붙인 식별은 MBR 없이 센 런별 식별보다 오류가 많습니다. MaxQuant에서 1.6배, FragPipe에서 2.5배입니다. 하지만 출발점이 아주 낮아서 1%와는 거리가 멉니다. 이 데이터에서 거짓 식별이 나오는 곳은 MBR이 아니었습니다.
DIA-NN은 옮겨 붙인 행을 표시하지 않습니다. DIA-NN의 MBR은 1차 결과로 만든 라이브러리로 모든 런을 다시 검색하는데, 그렇게 하자 모든 수준에서 entrapment가 줄었습니다(entrapment 프리커서가 MBR on 100개, off 189개). entrapment 프리커서가 다시 검색되려면 1차를 통과해야 하기 때문일 가능성이 큽니다. FragPipe의 combined_ion.tsv에는 MBC라는 표시도 있었습니다. IonQuant 문서에는 설명이 없지만 MBR은 아닙니다. MBR off에서도 같은 12,440개가 나왔습니다.
DB가 커진 대가
점수를 매길 펩타이드가 41% 늘자 진짜 식별도 줄었습니다. 표적만 넣은 검색과 비교하면 DIA-NN은 프리커서의 8.38.5%를, MaxQuant는 3.54.0%를(양 끝은 서로 다른 표적 전용 검색과 비교한 값이고, MBR은 여기서 아무것도 바꾸지 않습니다), FragPipe는 1.2%를 잃었습니다. 「혹시 모르니」 FASTA를 키우는 일(UniProt 전체, 다른 종, 모든 아이소폼)이 공짜가 아닙니다. 여기서는 DIA-NN의 라이브러리 없는 검색이 가장 큰 값을 치렀습니다.
도중에 망가진 두 가지
둘 다 파일이 어디 있느냐의 문제였고, 둘 다 몇 시간이 들었습니다. MaxQuant는 raw 파일 옆에 큰 중간 폴더를 씁니다. 이 6개 런에서는 첫 검색이 끝나기 전에 30 GB가 됐습니다. 저는 모든 것을 WSL에서 돌렸는데, WSL의 가상 디스크는 Windows C: 드라이브에 있습니다. 그래서 리눅스 쪽에서는 105 GB가 남아 보이는데 C:가 가득 찼고, 검색 도중 WSL이 꺼졌습니다. 나중에는 같은 드라이브에 있는 Windows 페이지 파일도 검색들이 메모리를 많이 잡으면서 64 GB에서 79 GB로 커졌습니다. 작업 폴더를 다른 드라이브로 옮겨 해결했습니다.
그러자 FragPipe가 그 드라이브에서 7분 반쯤 만에 「MSFragger move pepxml」 단계에서 Operation not permitted로 멈췄습니다. 결과 파일을 mzML 폴더에서 작업 폴더로 옮기면서 파일 속성까지 복사하려 하는데, WSL에 연결한 Windows 드라이브가 이를 거부합니다. 작업 폴더를 mzML 파일과 같은 파일 시스템에 두자 검색 하나가 15분쯤에 끝났습니다.
이 결과로 무엇을 할까
이 데이터에서 프리커서와 펩타이드의 1% FDR은 세 도구 모두, MBR을 켜든 끄든 지켜졌습니다. 펩타이드 수준에서 분석한다면 이 시험에서는 의심할 이유를 찾지 못했습니다. 단백질 목록은 더 조심해야 합니다. 바이오마커 후보나 「시료에서 검출됨」처럼 단백질 목록 자체가 중요한 경우, 이 도구와 설정에서 보고된 단백질 1% FDR이 1.3~2%까지일 수 있다고 감안하세요. 펩타이드 두 개 이상을 요구하면 여기 거짓 그룹 대부분이 빠지지만, FragPipe 진짜 단백질 그룹의 14%와 MaxQuant의 10%도 함께 잃습니다. 펩타이드 하나로 잡힌 단백질을 직접 확인하는 편이 덜 비쌉니다. 그리고 MBR을 켰을 때와 껐을 때를 비교한다면 런별로 세세요. 그러지 않으면 아무 차이도 보이지 않습니다.
한계
데이터 하나, entrapment 방식 두 가지, 설정마다 검색 한 번입니다. 그래서 엔진 사이의 작은 차이(0.26% 대 0.35%)에는 큰 뜻이 없습니다. DIA-NN은 같은 시료의 다른 측정(Orbitrap DDA 대신 TripleTOF SWATH)을 봤으니 다른 두 도구와는 느슨하게만 비교하세요. 결합 추정치는 r과, 거짓 식별이 자기 비율대로 entrapment에 떨어진다는 가정에 기대는데, 이 가정은 단백질 그룹보다 펩타이드에서 더 잘 맞습니다. FragPipe의 오염 단백질은 contam_ 접두어가 없어 표적으로 셌고, 그래서 FragPipe 추정치가 아주 조금 낮게 나옵니다. DIA-NN의 MBR off 검색은 MBR on 검색의 1차 결과를 다시 썼는데, DIA-NN은 이렇게 하면 새로 분석한 결과와 달라진다고 경고합니다. 앞 글의 표적 전용 MBR off 검색도 같은 방식으로 만들었습니다. paired 추정치는 섞은 표적 entrapment에서만 쓸 수 있습니다(위 업데이트 참고).
직접 재현하기
DB 만드는 스크립트, 검색 목록 형식, 세 엔진 출력을 세는 스크립트, 채점 스크립트, 집계와 그림: sbmlab-benchmarks/entrapment-fdr-hye. 정답 35개를 심은 가짜 데이터 시험이 엔진별 출력 형식의 집계를 확인합니다. 검색 결과 자체는 수십 GB라 올리지 않았습니다.
참고 문헌
- Wen B, Freestone J, Riffle M, MacCoss MJ, Noble WS, Keich U. Assessment of false discovery rate control in tandem mass spectrometry analysis using entrapment. Nat Methods 2025;22(7):1454-1463.
- Van Puyvelde B, et al. A comprehensive LFQ benchmark dataset on modern day acquisition strategies in proteomics. Sci Data 2022;9:126.
- Elias JE, Gygi SP. Target-decoy search strategy for increased confidence in large-scale protein identifications by mass spectrometry. Nat Methods 2007;4(3):207-214.
함께 보기
관련 글
LC-MS/MS Proteomics 입문 — 샘플 준비부터 데이터 분석까지 완전 가이드 2026
5월 18일 · 23 min read
프로테오믹스DIA-NN 2.7.0 업그레이드: 정답 아는 데이터로 2.3.2와 비교해 보니
11월 1일 · 20 min read
바이오인포매틱스bcftools와 GATK HaplotypeCaller를 GIAB HG002 정답으로 채점했습니다: SNP는 동점, 인델은 차이가 컸고 하드 필터는 진짜 변이를 지웠습니다
11월 14일 · 13 min read
Proteomics공동연구자 의뢰로 Park et al. 2026을 재현하다 — 종간 ECM 프로테오믹스 분석에서 3번 반복하며 잡은 것들
5월 19일 · 20 min read