같은 유전자 목록인데 GO 농축 결과가 다르다: GO 릴리스만 바꿨을 때 얼마나 바뀌는지 (2016~2025 실측)
같은 유전자 목록을 같은 GO 과대표현 분석으로 2016년부터 2025년까지 네 개의 Gene Ontology 릴리스에 돌렸습니다. 심어 둔 정답과 무작위 목록은 문제가 없었지만, 실제 덱사메타손 목록은 유의한 용어가 26개만 겹쳤고 「response to glucocorticoid」는 2016년 주석으로 찾지 못했습니다.
아래 숫자는 정답을 아는 유전자 목록과 공개 RNA-seq 데이터를 보관된 GO 릴리스에 돌려서 나왔습니다. 스크립트, 결과, 그림은 공개해 두었고, 다른 컴퓨터에서 다시 돌려 결과 표가 바이트 단위로 같게 나오는 것을 확인했습니다. (English version)
요약
- 유전자 목록, 식별자, 목록별 전체 유전자 집합, 검정은 그대로 두고 Gene Ontology 릴리스만 바꿨습니다. 2016년 1월, 2020년 1월, 2023년 1월, 2025년 10월입니다.
- 심어 둔 정답은 살아남았습니다. 300개 중 콜레스테롤 생합성 단백질 15개를 섞은 목록은 모든 릴리스에서 「cholesterol biosynthetic process」를 찾았습니다.
- 무작위 목록은 깨끗했습니다. 무작위 단백질 300개 목록 20개는 한 릴리스의 한 목록에서 용어 2개가 나온 것 말고는 유의한 용어가 없었습니다(목록과 릴리스 조합 80개 중 1개). FDR 기준이 허용하는 수준입니다.
- 실제 목록은 크게 바뀌었습니다.
airway데이터에서 덱사메타손으로 올라간 유전자는 2016년 릴리스로 유의한 용어 65개, 2025년으로 84개가 나왔고, 겹치는 것은 26개뿐입니다(Jaccard 0.21). - 예상한 생물학도 릴리스에 따라 달랐습니다. 덱사메타손은 글루코코르티코이드인데, 2016년 릴리스로는 「response to glucocorticoid」가 유의하지 않았습니다(FDR 0.21). 2020년부터는 유의했습니다(FDR 0.005~0.027).
- 실무 결론: 도구 버전만 적지 말고 GO 릴리스 날짜를 적으세요. 예전 분석과 비교하기 전에는 같은 릴리스로 다시 돌리세요.
왜 이 질문인가
농축 분석 도구는 모두 Gene Ontology의 어느 한 시점을 읽습니다. 온톨로지(용어와 그 위아래 관계)와 주석(어느 유전자가 어느 용어를 갖는지) 둘 다입니다. 큐레이터가 둘 다 계속 고치고, 도구가 언제 시점의 GO를 쓰는지는 도구와 버전마다 다릅니다. Wadi 등(2016)은 많이 쓰는 도구 상당수가 몇 년 지난 주석으로 돌고 있었고, 그 때문에 농축 결과가 달라진다는 것을 보였습니다.
저희가 알고 싶었던 것은 목록이 전혀 바뀌지 않아도 결과가 얼마나 바뀌는가였습니다. 그리고 사람들이 실제로 읽는 부분이 바뀌는가. 심어 둔 정답은 살아남는지, 무작위 목록은 깨끗한지, 실제 실험의 예상 생물학이 나오는지입니다.
측정 조건
| 항목 | 내용 |
|---|---|
| GO 릴리스 | 2016-01-01, 2020-01-01, 2023-01-01, 2025-10-10의 go-basic.obo와 사람 GAF(goa_human.gaf.gz), GO 릴리스 보관소에서 받음 |
| 무작위 목록 | 공개 벤치마크에서 DIA-NN이 검출한 사람 단백질 5,661개 중 300개씩 뽑은 20개. 정답: 용어 없음 |
| 심어 둔 목록 | 목록 5개: 검출된 Reactome 콜레스테롤 생합성 단백질 16개 중 15개 + 다른 검출 단백질 285개. 정답: 「cholesterol biosynthetic process」(GO:0006695) |
| 실제 목록 | Bioconductor airway(Himes 등 2014): 기도 평활근 세포주 4개, 덱사메타손 대 무처리. DESeq2 짝 설계 ~ cell + condition. 검정한 16,596개 중 511개 상승, 489개 하강(padj < 0.05, |log2FC| ≥ 1) |
| 검정 | 단측 초기하 검정(과대표현 분석). 배경에서 주석 유전자가 10~500개인 용어, GO 세 영역 모두, Benjamini-Hochberg, FDR < 0.05면 유의 |
| 배경 | 목록의 전체 집합(검출 단백질 전체, 또는 UniProt이 있는 검정 유전자 13,195개) 중 그 릴리스에서 주석이 있는 것 |
| 식별자 | 고정: UniProt accession, 유전자는 HGNC 표 하나로 연결 |
| 근거 코드 | 두 가지: 모든 근거 코드, 그리고 IEA(전자 주석)를 뺀 것 |
목록은 어느 릴리스도 읽기 전에 정해 두었습니다. 주석은 대부분의 도구처럼 is_a와 part_of를 따라 상위 용어로 전파했습니다. 두 종류의 변화를 나누려고 혼합 실행도 했습니다. 2016년 주석을 2025년 온톨로지로 읽었습니다.
결과
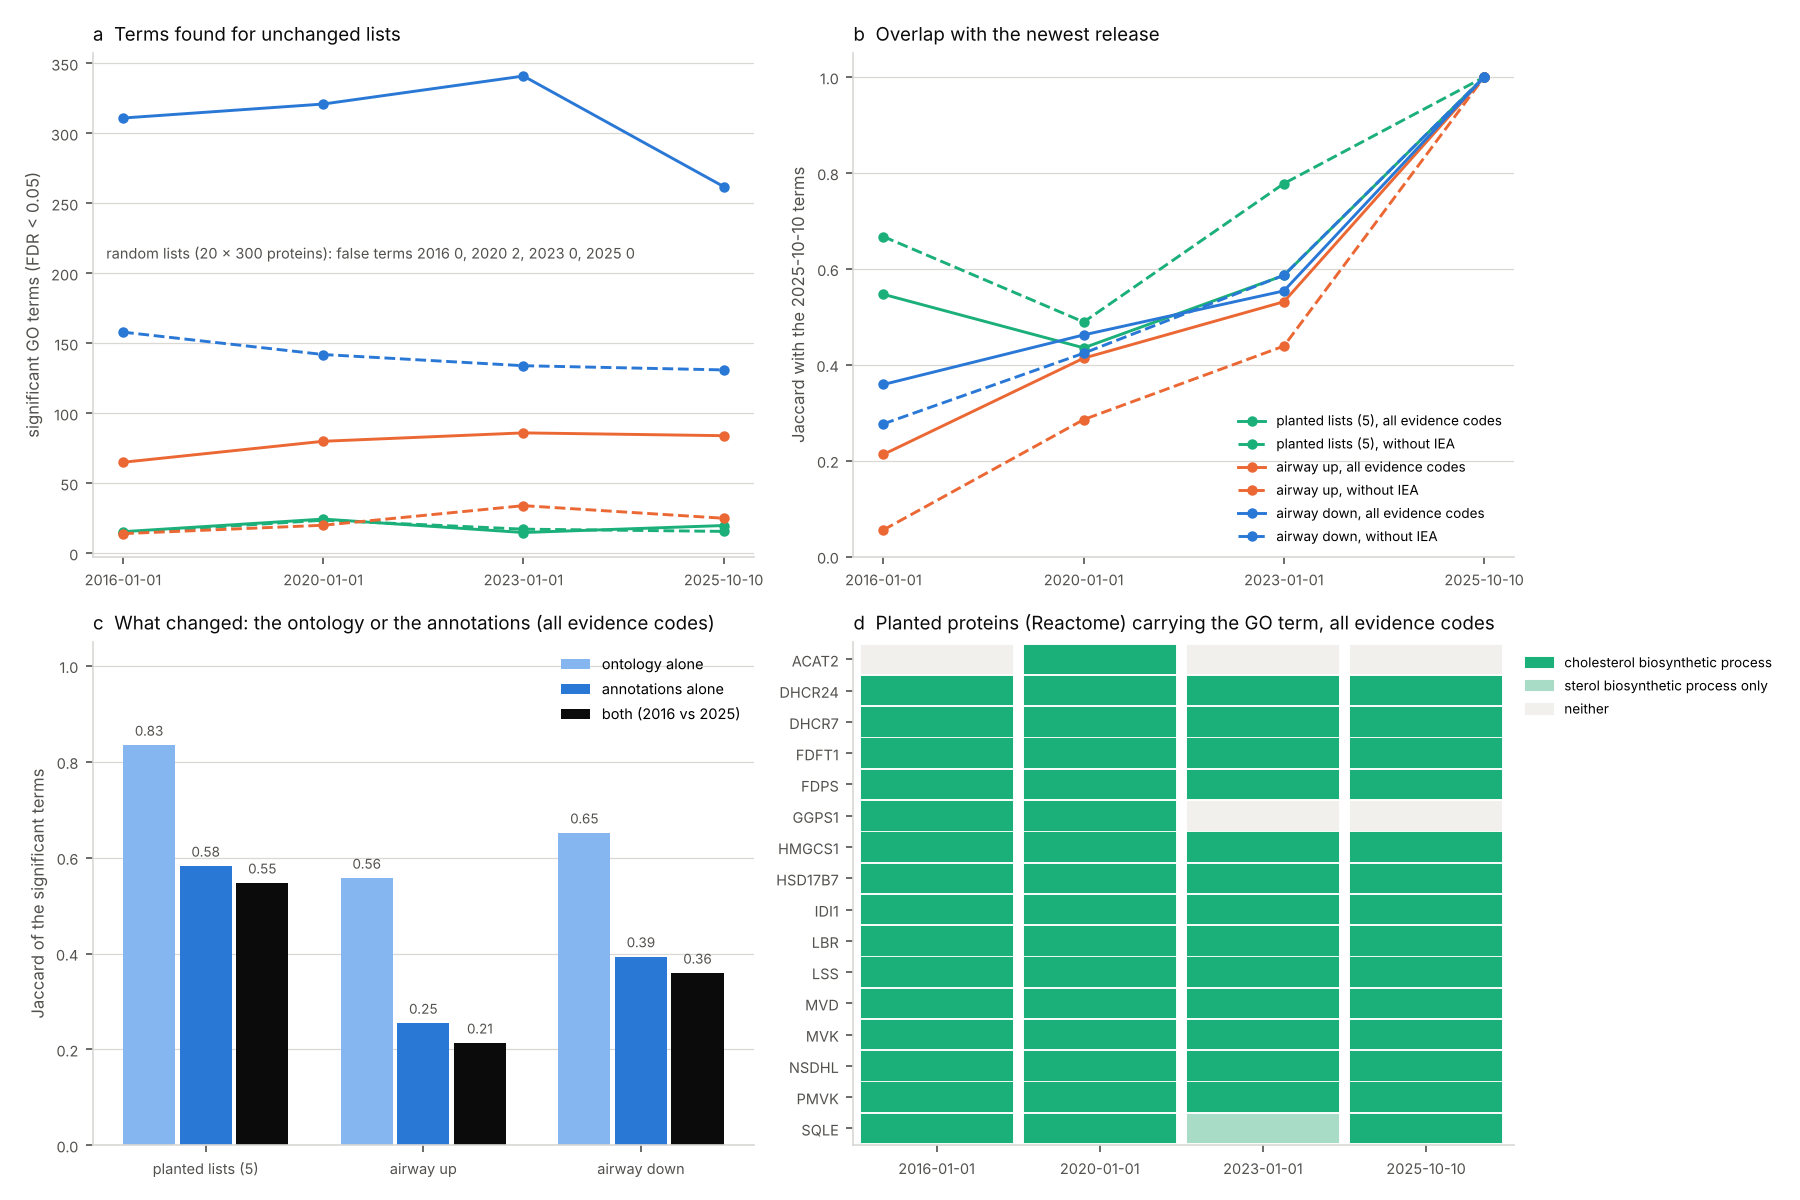
모든 근거 코드:
| 릴리스 | 무작위 목록 20개의 가짜 용어 | 정답을 찾은 심어 둔 목록 | airway 상승: 용어 수 | airway 하강: 용어 수 | 「response to glucocorticoid」 FDR (순위) |
|---|---|---|---|---|---|
| 2016-01-01 | 0 | 5/5 | 65 | 311 | 0.207 (285) |
| 2020-01-01 | 2 (목록 1개) | 5/5 | 80 | 321 | 0.005 (16) |
| 2023-01-01 | 0 | 5/5 | 86 | 341 | 0.027 (66) |
| 2025-10-10 | 0 | 5/5 | 84 | 262 | 0.025 (49) |
2025-10-10 릴리스와 유의 용어가 겹치는 정도 (Jaccard: 겹치는 용어 수를 두 집합의 합집합 크기로 나눈 값. 심어 둔 목록은 5개 평균):
| 릴리스 | 심어 둔 목록 | airway 상승 | airway 하강 | airway 상승, IEA 제외 | airway 하강, IEA 제외 |
|---|---|---|---|---|---|
| 2016-01-01 | 0.55 | 0.21 | 0.36 | 0.06 | 0.28 |
| 2020-01-01 | 0.44 | 0.41 | 0.46 | 0.29 | 0.42 |
| 2023-01-01 | 0.59 | 0.53 | 0.55 | 0.44 | 0.59 |
숫자가 말하는 것
1. 심어 둔 정답은 모든 릴리스에서 살아남았습니다. 심어 둔 목록 5개 모두 네 릴리스, 두 근거 설정에서 「cholesterol biosynthetic process」를 1~5위로 찾았습니다. 다만 그 주변 용어는 바뀌었습니다. 2016년과 2025년 사이 심어 둔 목록의 유의 용어 Jaccard는 평균 0.55입니다.
2. 무작위 목록은 깨끗했습니다. 무작위 목록 20개를 네 릴리스에 돌린 80번 중, 2020년 릴리스의 목록 하나에서 DNA 복제 용어 2개(FDR 0.024~0.027)가 나왔고 나머지 79번은 없었습니다. 릴리스를 바꿔도 무작위 목록의 위양성은 FDR 기준이 허용하는 수준을 넘지 않았습니다.
3. 실제 목록은 크게 바뀌었습니다. 덱사메타손 상승 목록은 2016년 릴리스로 유의한 용어 65개, 2025년으로 84개이고, 둘 다에 있는 것은 26개입니다. 거꾸로 말하면 2016년 용어 65개 중 26개(40%)만 2025년에도 유의합니다. 하강 목록은 조금 낫습니다(Jaccard 0.36). 이 겹침은 한 가지 기준(FDR < 0.05)에서 잰 것이라, 일부는 그 기준을 넘나든 용어입니다. 또 릴리스마다 검정한 용어 수가 달라서 다중 검정 보정도 달라집니다.
4. 예상한 생물학은 새 릴리스에서만 나왔습니다. 「response to glucocorticoid」(GO:0051384)는 덱사메타손으로 올라간 유전자에서 교과서적으로 기대하는 답입니다. 2016년 릴리스로는 285위, FDR 0.21이었습니다. 2020년에는 16위(FDR 0.005)였고, 2023년과 2025년에도 유의했습니다. 혼합 실행(2016년 주석, 2025년 온톨로지)에서도 FDR 0.19였습니다. 그러니 이 용어를 놓친 것은 2016년 온톨로지가 아니라 2016년 주석입니다.
5. 이 목록에서는 예상한 용어가 전자 주석에 달려 있었습니다. IEA 주석을 빼면 「response to glucocorticoid」는 한 번도 유의하지 않았습니다(FDR 0.861.0). 2025년 릴리스에서 이 용어나 그 아래 용어로 주석된 사람 단백질 139개 중 99개는 IEA로만 이 용어를 갖습니다. 그 행 대부분은 GO_REF:0000107을 근거로 하며, 다른 종의 오솔로그에 붙은 실험 주석을 옮겨 온 주석입니다. IEA를 빼는 것이 더 엄격한 선택처럼 소개되곤 하지만, 이 목록에서는 예상한 용어가 사라졌습니다. IEA를 빼면 이 용어 자체도 작아져서(배경에서 주석 유전자 1120개, 목록에 1~2개) 이 결과는 조심해서 읽어야 합니다.
6. 결과에 닿는 부분에서는 주석이 온톨로지보다 많이 바뀌었습니다. 2016년 주석을 2025년 온톨로지로 읽으면 2016년 유의 용어와 Jaccard 0.560.83이 남았고, 온톨로지를 고정하고 주석만 바꾸면 0.250.58이 남았습니다. 단백질 하나하나로 보면 두 변화는 비슷합니다(평균 Jaccard 0.63과 0.61). 2016년과 2025년 둘 다 주석이 있는 검출 단백질 5,569개 중, 전파된 용어 집합이 완전히 같은 것은 16개뿐입니다.
7. 심어 둔 유전자조차 들락날락했습니다. 검출된 Reactome 콜레스테롤 생합성 단백질 16개 중 GO 용어를 가진 것은 릴리스에 따라 1316개입니다(모든 근거 코드 기준, IEA를 빼면 1116개). ACAT2는 2020년에만 갖고, GGPS1은 2020년 뒤에 잃고, SQLE는 2023년에 더 넓은 「sterol biosynthetic process」만 갖습니다(그림 d). 그래도 심어 둔 용어를 찾은 것은 목록마다 다른 심어 둔 단백질이 충분히 용어를 지켰기 때문입니다.
어떻게 하면 되나
- 도구 버전만 적지 말고 GO 릴리스 날짜를 적으세요. 같은 검정, 같은 목록이라도 릴리스마다 답이 달랐습니다. 예를 들어 Bioconductor에서는
GO_dbInfo()와org.Hs.eg_dbInfo()의GOSOURCEDATE가 온톨로지 날짜이고,org.Hs.eg.db의 유전자 주석은 NCBI gene2go 파일에서 오며 그 날짜는GOEGSOURCEDATE입니다. 이 사이트에 쓰는 R 4.3 환경에서는 각각 2023-07-27과 2023-Sep11로, 이 글의 최신 릴리스보다 2년 넘게 앞섭니다. g:Profiler 같은 웹 도구는 결과와 함께 데이터 버전을 보여 줍니다. - 비교하기 전에 다시 돌리세요. 논문에 실린 농축 결과나 2년 전 내 분석과 비교한다면, 두 목록을 먼저 같은 릴리스로 돌리세요. 그러지 않으면 차이의 일부는 릴리스 차이입니다.
- IEA를 습관처럼 빼지 마세요. 이 목록에서는 예상한 용어가 사라졌습니다. 뺀다면 그렇다고 적고, 용어가 더 적고 작아질 것을 예상하세요.
- 식별자를 고정하세요. 유전자 기호 대신 안정적인 ID(Ensembl, UniProt)로 한 번만 연결해야 기호 이름이 바뀐 것까지 차이에 더해지지 않습니다.
- 기준 근처의 용어 하나는 불안정하다고 보세요. 한 릴리스에서 FDR 0.03인 용어가 다른 릴리스에서 0.2일 수 있습니다. 여기의 콜레스테롤 용어처럼 릴리스를 바꿔도 유지되는 용어를 이야기의 중심에 두세요.
한계
- 실제 실험은 하나(
airway의 덱사메타손), 기준도 하나이고 과대표현 분석만 했습니다. GSEA, 다른 생물종, 다른 유전자 집합 데이터베이스(KEGG, Reactome, MSigDB)는 재지 않았습니다. - 특정 도구가 아니라 직접 만든 검정입니다. GO 컨소시엄의 사람 GAF를 직접 읽었습니다. 다른 곳에서 주석을 가져오는 도구(예: NCBI gene2go로 만든
org.Hs.eg.db)는 릴리스 사이에 다르게 움직일 수 있고, 그런 도구는 돌리지 않았습니다. - 릴리스는 네 개입니다. 2026년 릴리스는 보관소 목록에는 있었지만 측정할 때 파일을 받을 수 없어서, 2025년 10월이 가장 최신입니다.
- 혼합 실행은 변화를 한 순서(온톨로지 먼저)로만 나눴습니다. 폐기된 용어는 대체 용어로 옮기지 않고 버렸기 때문에, 큐레이터가 옮긴 주석 일부를 주석 변화로 셌습니다.
- 유전자는 2025년 HGNC 표로 연결했습니다. 그래서 2016년 뒤에 합쳐진 UniProt accession은 2016년 주석 일부를 잃을 수 있습니다.
재현
데이터, 스크립트, 결과, 그림: sbmlab-benchmarks/go-release-drift. bash download.sh가 GO 릴리스 네 개, HGNC 표, airway 데이터(약 180MB, md5sums.txt로 확인)를 받고, python3 enrich.py가 Python 표준 라이브러리만으로 모든 목록을 모든 릴리스에 1분 안에 돌립니다. test/test_go_ora.py는 OBO와 GAF 읽기, 전파, 초기하 꼬리 확률(정확한 합과 비교), Benjamini-Hochberg를 확인합니다.
참고 문헌
- Wadi L, Meyer M, Weiser J, Stein LD, Reimand J. Impact of outdated gene annotations on pathway enrichment analysis. Nat Methods 2016;13(9):705-706.
- Himes BE, et al. RNA-Seq transcriptome profiling identifies CRISPLD2 as a glucocorticoid responsive gene that modulates cytokine function in airway smooth muscle cells. PLoS One 2014;9(6):e99625. (
airway데이터) - Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol 2014;15:550.
- The Gene Ontology Consortium. The Gene Ontology knowledgebase in 2023. Genetics 2023;224(1):iyad031.
함께 읽기
관련 글
WGCNA는 정말 효과가 있을까 — 공개 단백체 데이터로 처음부터 끝까지 재 본 결과
10월 23일 · 21 min read
Proteomics공동연구자 의뢰로 Park et al. 2026을 재현하다 — 종간 ECM 프로테오믹스 분석에서 3번 반복하며 잡은 것들
5월 19일 · 20 min read
바이오인포매틱스배치 보정하고 검정하면 괜찮을까? 그룹이 배치에 고르지 않으면 ComBat이 목표 5%인 가짜 양성을 29%로 만든다
11월 4일 · 16 min read
바이오인포매틱스군마다 시료가 셋뿐일 때: t-검정을 limma로 바꾸면서 알게 된 것
10월 28일 · 17 min read