WGCNA는 정말 효과가 있을까 — 공개 단백체 데이터로 처음부터 끝까지 재 본 결과
CPTAC 신장암 종양 110개로 WGCNA 표준 흐름을 돌리고 다른 코호트에서 다시 확인했습니다. 모듈은 진짜였지만, 등급과 유의한 모듈 7개 중 같은 크기 무작위 묶음을 넘은 것은 2개였고 가장 센 모듈은 혈관 함량이었습니다.
WGCNA(가중 유전자 공발현 네트워크 분석)는 오믹스 논문에서 가장 많이 쓰이는 방법 가운데 하나입니다. 흔한 흐름은 「모듈을 찾고 → 형질과 엮인 모듈을 고르고 → 그 안의 허브 유전자를 핵심 표적으로 제시」하는 것입니다. 저희는 이 흐름을 공개 데이터로 처음부터 끝까지 돌리면서, 중간 선택값을 바꾸고, 표본을 줄이고, 다른 코호트에서 다시 확인하고, 무작위 묶음과 비교했습니다. 결론은 **「함께 움직이는 덩어리를 찾는 데는 잘 된다. 그러나 형질을 설명하는 핵심 유전자를 찾는 데는 생각보다 약하다」**입니다. 사용한 자료는 공개 데이터(CPTAC 신장암 · TJ-RCC)와 공개 논문뿐입니다. (고객 자료는 쓰지 않았습니다.) (English: Does WGCNA Really Work?)
같은 무리로 다니는 학생들
학교에서 누가 누구와 같이 다니는지 기록해 「무리」를 나눈다고 해 보겠습니다. 무리는 분명히 나옵니다. 그런데 그 무리가 「친해서」 생긴 것일까요?
- 같은 동네라 같은 버스를 타서 늘 같이 다니는 것일 수도 있고,
- 같은 동아리라서 일 수도 있고,
- 정말 마음이 맞아서일 수도 있습니다.
그리고 「성적이 좋은 무리」를 찾았다고 해도, 그 무리의 「가장 인기 많은 학생」이 성적을 올린 사람이라는 보장은 없습니다.
WGCNA 의 모듈과 허브도 같습니다. 모듈은 확실히 나옵니다. 문제는 그 모듈이 무엇 때문에 생겼는지, 그리고 형질과의 연관이 「아무 묶음보다 나은지」입니다.
무엇을 했나
| 항목 | 내용 |
|---|---|
| 발견 코호트 | CPTAC 신장암(투명세포형) 종양 110개 단백체 · 병리 등급(grade) G1 7 · G2 51 · G3 41 · G4 11 |
| 재현 코호트 | TJ-RCC 종양 100개 단백체 (다른 나라 · 다른 기기 · 다른 처리) |
| 단백질 | 두 코호트 공통 · 결측 10% 이하(TJ-RCC 의 값 0 은 결측으로 처리) 중 발견 코호트 분산 상위 3,000개 |
| 기본 설정 | 모듈 자르기 값은 WGCNA 튜토리얼 그대로(minModuleSize 30 · deepSplit 2 · mergeCutHeight 0.25), 망은 signed · power 10(scale-free 적합 R² 0.80 을 처음 넘는 값). 튜토리얼 자체는 unsigned · power 6 입니다. |
| 실험 | ① 선택값 하나씩 바꾸기 ② 표본 줄이기 ③ 다른 코호트·다른 분자층에서 다시 보기 ④ 같은 크기 무작위 묶음과 비교 ⑤ 세포 표지로 모듈 정체 확인 ⑥ 예측 성능 비교 |
종양만 쓴 이유가 있습니다. 종양과 정상을 섞으면 모듈이 「종양 대 정상」 차이로 쏠립니다. 재현 코호트에 정상을 넣어(TJ-RCC 종양 100 + 정상 50) 같은 방법으로 돌려 보니 가장 큰 두 모듈이 종양-정상과 r −0.82 · 0.74 였고, 그 안의 47.5% · 27.5% 가 이미 차등 단백질이었습니다. 군 차이가 큰 설계에서 WGCNA 는 차등 분석을 한 번 더 하는 것에 가깝습니다.
1. 좋은 소식 — 모듈은 진짜 「덩어리」다
- 모듈 15개 모두 GO 생물학적 과정이 유의했습니다. 같은 크기의 무작위 단백질 묶음 200개에서는 5% 만 유의했습니다.
- 미토콘드리아 호흡 · 리보솜 · RNA 스플라이싱 · 보체 · 세포외기질처럼 「같이 만들어지고 같이 일하는」 묶음이 깨끗하게 갈렸습니다.
- 다른 나라 · 다른 기기에서 잰 코호트에서도 15개 중 12개가 크기를 맞춘 무작위 모듈보다 높게 보존됐습니다.
WGCNA 가 데이터의 구조를 보여 주는 도구로는 제 역할을 한다는 뜻입니다.
2. 중간 선택값 — 어디서 결과가 갈리나
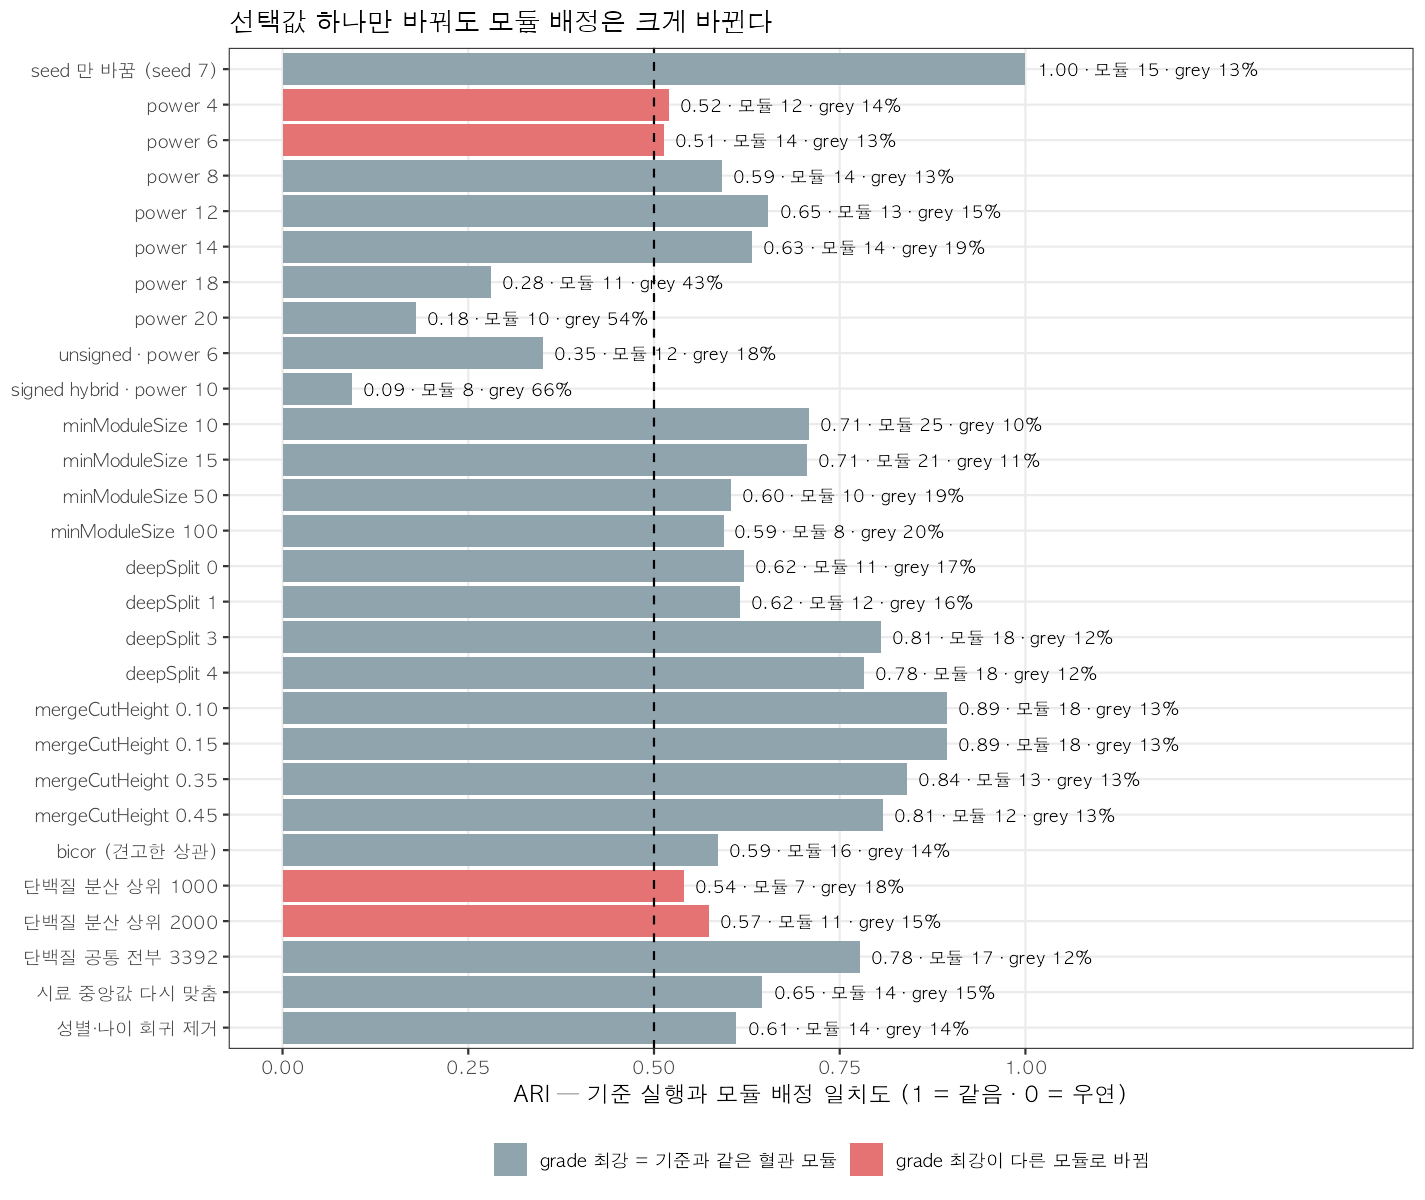
막대는 「기준 실행과 같은 단백질을 같은 모듈에 넣었나」의 일치도(ARI, 1 = 같음 · 0 = 우연 수준)입니다. 빨간 막대는 「등급과 가장 센 모듈」이 다른 모듈로 바뀐 경우 — 즉 논문의 결론 문장이 달라지는 경우입니다.
- soft power — 같은 그래프(튜토리얼의 power 후보 1~10, 이후 20까지 짝수)에서 「scale-free 적합 R²」 기준선을 0.80 으로 그으면 power 10, 0.85 면 18, 0.90 이면 20 이 됩니다. 패키지의 자동 추천은 18 을 줍니다. (power 를 정수마다 다 보면 17 · 19 입니다.) power 18 에서는 평균 연결 수가 약 2 로 떨어져 단백질의 43% 가 어느 모듈에도 들지 못했습니다. 반대로 power 4 · 6 으로 낮추면 「등급과 가장 센 모듈」 자체가 다른 모듈로 바뀌었습니다.
- 망 종류 — unsigned(관례대로 power 6)로 바꾸면 일치도 0.35, signed hybrid(power 10)는 0.09 까지 떨어졌습니다. 사실상 다른 분석입니다.
- 입력 단백질 수 — 분산 상위 1,000개만 쓰면 「등급 모듈」이 면역 모듈로, 2,000개면 ER·골지 모듈로 바뀌었습니다.
- 반대로 모듈을 얼마나 잘게 자를지(minModuleSize · deepSplit · mergeCutHeight)는 덜 민감했습니다. 모듈 수는 바뀌어도 큰 덩어리는 유지됐습니다.
scale-free 를 기준으로 power 를 고르는 근거 자체도 약합니다. 실제 망 928개를 조사한 연구에서 scale-free 의 가장 강한 증거 수준을 보인 것은 4% 였습니다 [1]. RNA-seq 공발현 망으로 유전자 기능(GO)을 맞히는 평가에서는 soft threshold 가 단순 상관보다 오히려 성능을 낮췄습니다 [2]:
"Also, the WGCNA soft thresholding acts in a similar fashion, lowering performance (average AUROC = 0.55)."
정리하면 「입력 집합 · power · 망 종류」는 결과를 바꿉니다. 이 셋은 값과 이유를 적고, 두세 값으로 돌려 결론이 유지되는지 보여야 합니다.
3. 표본 수 — 몇 개부터 믿을 수 있나
110개 중 n 개를 뽑아 20번씩 다시 돌렸습니다.
| 표본 수 | 전체 결과와 일치도(ARI) | 등급과 가장 센 상관 | 「등급 모듈 발견」 보고율 (p < 0.05) |
|---|---|---|---|
| 15 | 0.19 | 0.66 | 75% |
| 20 | 0.24 | 0.59 | 95% |
| 30 | 0.29 | 0.57 | 90% |
| 60 | 0.43 | 0.47 | 100% |
| 80 | 0.48 | 0.49 | 100% |
(전체 110개에서의 가장 센 상관 = 0.46)
표본이 15개면 모듈 배정은 거의 다른 결과인데, 상관은 0.46 → 0.66 으로 부풀려지고, 그런데도 4번 중 3번은 「등급과 엮인 모듈을 찾았다」고 보고하게 됩니다. 작은 표본에서 「가장 센 것」을 고르면 생기는 승자의 저주입니다. 패키지 저자들의 권고도 「15개 미만은 하지 말고, 가능하면 20개 이상」입니다 [3].
4. 형질과 엮인 모듈 — 무작위 묶음과 비교해 보면
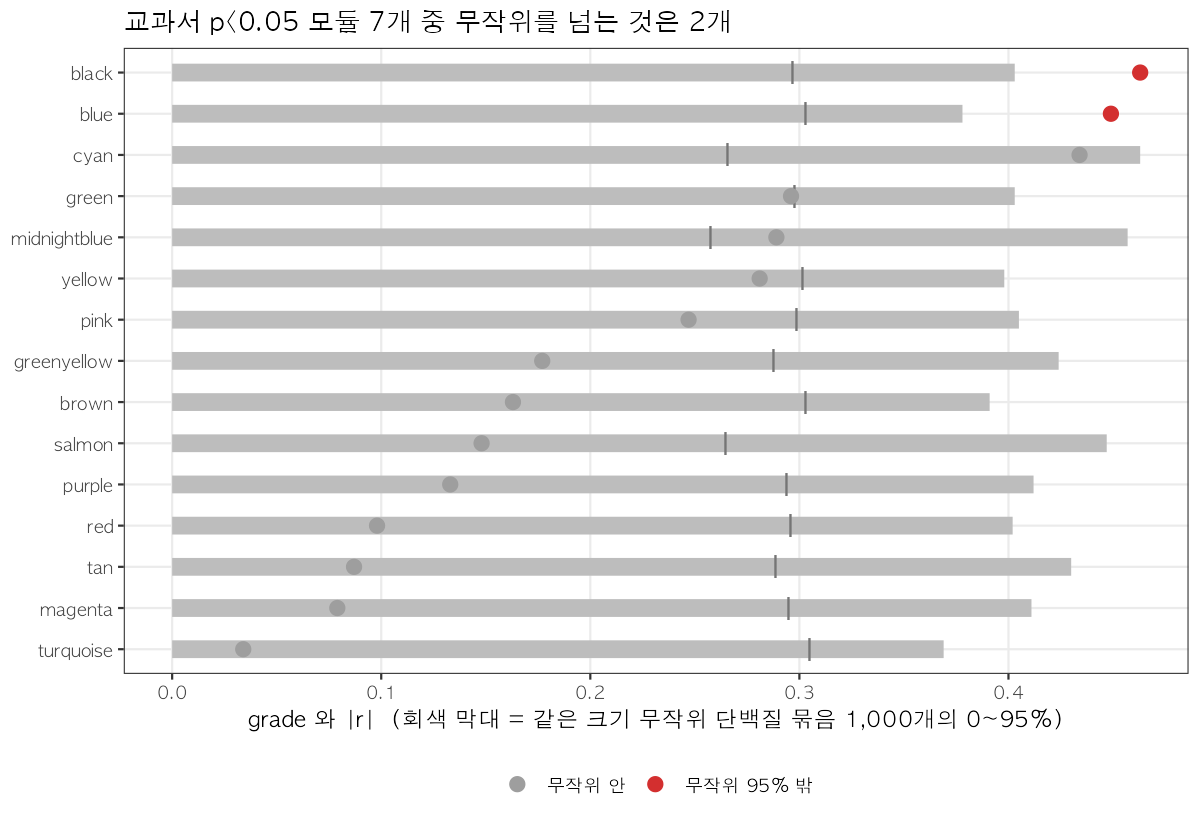
교과서 방식(모듈 대표값과 등급의 상관 + p 값)으로는 7개 모듈이 등급과 유의했습니다.
그런데 같은 크기의 무작위 단백질 묶음을 1,000번 뽑아 같은 계산을 하면, 그것도 등급과 |r| 0.30 쯤은 나옵니다. 등급이 데이터의 큰 축 중 하나라서, 아무 단백질이나 묶어 평균을 내도 그 축을 일부 잡기 때문입니다.
이 무작위 기준을 넘은 모듈은 2개뿐이었습니다(회색 막대 = 무작위 묶음의 95% 범위).
모듈-형질 p 값은 「상관이 0 이 아니다」를 검정할 뿐, 「아무 묶음보다 낫다」를 검정하지 않습니다.
5. 그 모듈의 정체 — 혈관 함량
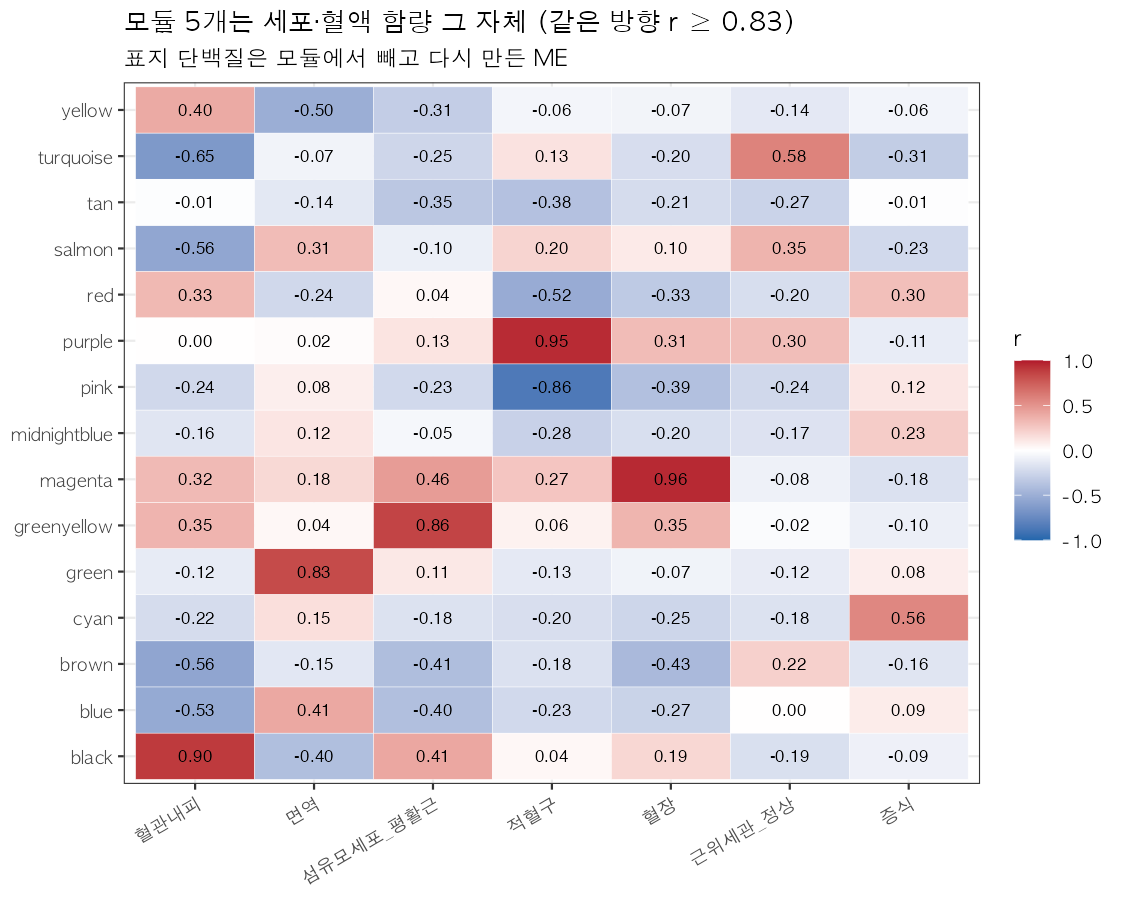
등급과 가장 센 모듈(r −0.46)의 허브는 RASIP1 · CDH13 · PLVAP … 였습니다. 모듈을 보지 않고 고른 표준 혈관내피 표지(PECAM1 · VWF · CDH5 · ENG · EMCN · ESAM)의 점수와 비교하니 r 0.90 이었습니다. 이 가운데 4개는 모듈에도 들어 있지만, 모듈에서 빼고 다시 계산해도 결과는 같았습니다. 혈관내피 점수로 보정하면 등급 상관은 −0.46 → −0.21 로 줄었습니다(여전히 p ≈ 0.03 이라 「사라졌다」가 아니라 「줄었다」입니다).
즉 「등급이 높을수록 이 모듈이 낮다」는 사실이지만, 그것은 종양세포 안의 조절 변화라기보다 조직 속 혈관 비율의 차이에 가깝습니다.
이것은 이 데이터만의 일이 아닙니다. 모듈 15개 중 5개가 세포·혈액 함량(면역 · 혈관 · 기질 · 적혈구 · 혈장)이었고, 뇌와 혈액 전사체(RNA)를 본 연구는 이렇게 결론 냈습니다 [4]:
"Our conclusion is that the dominant coexpression signal in brain, blood, and, likely, other complex tissues can be attributed to cellular compositional effects, rather than intra-cell-type regulatory relationships."
단백체에서는 하나가 더 있습니다. 혈장 단백 모듈과 적혈구 모듈은 같은 환자의 RNA 로는 다시 나오지 않았습니다. 그 조직이 만든 것이 아니라 혈액에서 들어온 단백질이기 때문입니다. 이런 모듈을 「조절 프로그램」으로 해석하면 틀립니다.
6. 모듈 보존 점수의 함정
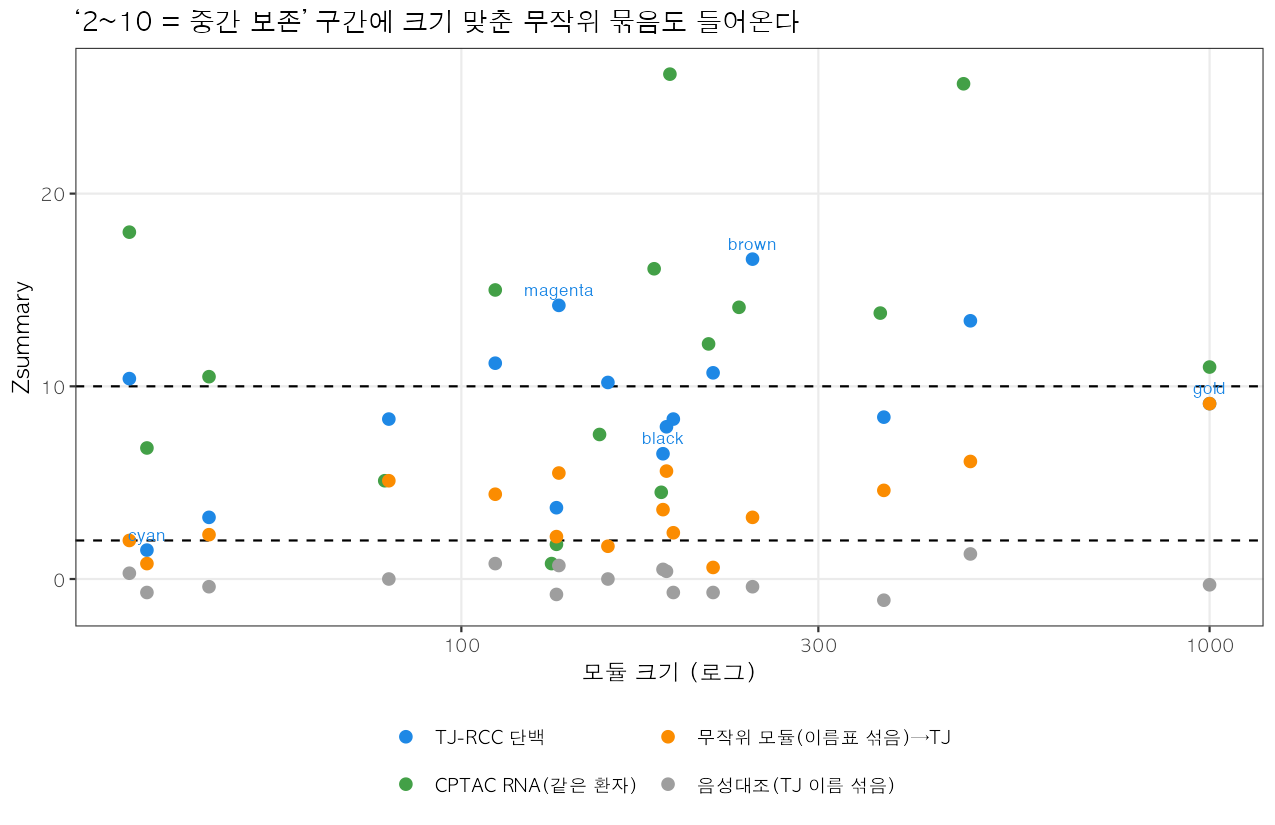
모듈이 다른 데이터에서도 있는지 보는 표준 지표(Zsummary)에는 널리 쓰이는 기준이 있습니다 [5]:
"…if [Zsummary > 10] there is strong evidence that the module is preserved; if [2 < Zsummary < 10] there is weak to moderate evidence of preservation; if [Zsummary < 2], there is no evidence that the module preserved."
그런데 저희가 모듈 이름표를 단백질 사이에서 섞어 크기만 같은 무작위 모듈을 만들어 넣어 보니, 15개 중 12개가 Z 2 이상(최대 6.1)이 나왔습니다. 무작위 1,000개 묶음은 9.1 이었습니다. 단백질 이름을 섞은 음성 대조는 −1.1 ~ 1.3 으로 도구 자체는 정상이었습니다.
같은 논문도 Z 값이 모듈 크기에 따라 커진다고 밝히고 있습니다 [5]. 「2~10 = 중간 보존」 구간에는 무작위 묶음도 들어옵니다. 크기를 맞춘 무작위 모듈을 나란히 보여 줘야 합니다.
7. 허브 유전자와 예측
허브는 안정적이지만, 중요하다는 뜻은 아닙니다. 표본을 30개로 줄였을 때 허브 10개 중 6개가 다시 나왔습니다(등급과 상관이 가장 큰 단백질 10개는 1개). 허브는 「모듈 평균과 가장 비슷하게 움직이는 것」이라 평균처럼 잡음이 줄기 때문입니다. 하지만 위의 혈관 모듈 허브는 그냥 혈관 표지였습니다.
WGCNA 를 만든 두 사람도 이렇게 썼습니다 [6]:
"While there is an ongoing debate in the literature regarding the importance of hub genes, it is fair to say hubs are often not important."
바로 다음 문장에서 저자들은 망 전체의 허브 대신 모듈 안의 허브에 집중해야 한다고 주장합니다. 이 글에서 본 허브가 바로 그 모듈 안 허브입니다.
"…while network methods may be preferable when learning about biology, standard marginal meta-analysis methods may be better suited for selecting candidate biomarkers."
예측에서도 모듈이 더 낫지 않았습니다. 고등급(G3·4) 예측을 교차검증으로 비교하니(AUC) 등급 상관 상위 단백질 50개 점수 0.73 · 주성분 15개 0.72 · 모듈 15개 0.70 이었습니다. 모듈은 「해석하기 쉬운 주성분」이지 「더 강한 주성분」이 아닙니다. 42개 방법을 비교한 벤치마크에서도 알려진 조절 모듈을 가장 잘 찾은 것은 분해(ICA) 계열이었습니다 [7]. 공정하게 덧붙이면, 같은 벤치마크에서 WGCNA 는 군집 방법 가운데서는 상위권이었습니다.
8. 그래서 저희는
- 표본이 20개 미만이면 WGCNA 를 권하지 않습니다. 20~30 은 구조를 살펴보는 용도로만, 모듈-형질 결론은 30개 이상에서 씁니다.
- 종양/정상처럼 군 차이가 큰 설계는 군 안에서 따로 분석합니다.
- power · 망 종류 · 입력 집합은 값과 이유를 적고, 두세 값으로 다시 돌려 결론이 유지되는지 함께 보여 드립니다.
- 모듈마다 GO 와 함께 세포·혈액 표지와의 상관을 붙입니다. 혈장·적혈구 모듈은 따로 표시합니다.
- 모듈-형질 연관에는 같은 크기 무작위 묶음과의 비교를, 보존 점수에는 크기를 맞춘 무작위 모듈을 나란히 붙입니다.
- 허브는 「후보」로만 드립니다.
마무리
WGCNA 는 「데이터 속에 어떤 덩어리가 있나」를 보는 데는 좋은 지도입니다. 세포 구성이나 혈액 혼입, 배치 같은 큰 축을 한눈에 보여 주고, 수천 개 변수를 수십 개 점수로 줄여 줍니다.
그러나 지도에 선이 그어졌다고 길이 난 것은 아닙니다. 모듈이 형질과 엮였다면 「아무 묶음보다 나은가」, 그리고 **「세포 구성 때문은 아닌가」**를 먼저 물어야 합니다. 그 두 질문을 통과한 뒤에야 허브는 「핵심」이 아니라 「검증할 후보」가 됩니다.
재현하기
wgcna-cptac-ccrcc 는 공개 자료(약 48MB)를 내려받아 핵심 숫자를 약 4분 30초 만에 다시 계산합니다. 모듈 수, 등급 유의 모듈 7개 중 무작위를 넘는 2개, 혈관 모듈과 그 보정, AUC 세 개입니다. 원래 분석과 따로, 위에 적은 설정만 보고 새로 짠 코드이며 숫자는 소수 둘째 자리까지 다시 나왔습니다(R 4.3.3, WGCNA 1.74). 「유의 모듈 7개」가 전처리에 따라 달라진다는 것도 함께 보여 줍니다. TJ-RCC 의 0 을 값으로 두면 3개, CPTAC 만으로 거르면 2개입니다. 어느 경우든 혈관 모듈이 가장 세고, 무작위를 넘는 모듈은 2~3개였습니다. GO · 보존 점수 · 표본 줄이기 표 · 선택값 막대는 다시 돌리지 않았습니다.
참고문헌
- Broido AD, Clauset A. Scale-free networks are rare. Nature Communications 2019;10:1017. doi:10.1038/s41467-019-08746-5
- Ballouz S, Verleyen W, Gillis J. Guidance for RNA-seq co-expression network construction and analysis: safety in numbers. Bioinformatics 2015;31(13):2123–2130. doi:10.1093/bioinformatics/btv118
- Langfelder P, Horvath S. WGCNA package: Frequently Asked Questions. (웹 문서, 2017-12 갱신) https://horvath.genetics.ucla.edu/html/CoexpressionNetwork/Rpackages/WGCNA/faq.html (보관본 · 현재 원 사이트는 인증서 경고가 뜹니다)
- Farahbod M, Pavlidis P. Untangling the effects of cellular composition on coexpression analysis. Genome Research 2020;30(6):849–859. doi:10.1101/gr.256735.119
- Langfelder P, Luo R, Oldham MC, Horvath S. Is my network module preserved and reproducible? PLoS Computational Biology 2011;7(1):e1001057. doi:10.1371/journal.pcbi.1001057
- Langfelder P, Mischel PS, Horvath S. When is hub gene selection better than standard meta-analysis? PLoS ONE 2013;8(4):e61505. doi:10.1371/journal.pone.0061505
- Saelens W, Cannoodt R, Saeys Y. A comprehensive evaluation of module detection methods for gene expression data. Nature Communications 2018;9:1090. doi:10.1038/s41467-018-03424-4
인용한 문장은 모두 해당 논문·문서 원문에서 확인한 것입니다([4]의 인용은 초록). 자료: CPTAC 투명세포 신장암 단백체(Clark DJ et al. Cell 2019;179(4):964–983.e31, doi:10.1016/j.cell.2019.10.007 · LinkedOmics 처리본) · TJ-RCC(Hu J et al. Nature Genetics 2024;56(3):442–457, doi:10.1038/s41588-024-01662-5 · Zenodo 8063124, CC-BY-4.0). 도구: R WGCNA 1.73. 형질은 병리 등급 하나를 중심으로 봤고, 세포 표지 점수는 표지 4~7개 평균입니다. 다른 조직 · 대사체 · 다른 형질에서 같은 숫자가 나온다고 단정할 수 없습니다.
관련 글
Does WGCNA Really Work? Running It End to End on Public Proteomics Data
10월 23일 · 12 min read
BioinformaticsIt Almost Worked: Four Ways a Multi-Omics Pipeline Nearly Reported a False Success
8월 10일 · 19 min read
Proteomics공동연구자 의뢰로 Park et al. 2026을 재현하다 — 종간 ECM 프로테오믹스 분석에서 3번 반복하며 잡은 것들
5월 19일 · 20 min read
BioinformaticsSTRING Confidence Score and Hub Proteins, Measured: What 0.4 vs 0.7 Changes and Whether Hubs Are Biology or Attention (STRING 12.5)
10월 19일 · 15 min read